データゼネラルNova
データゼネラル Nova (ノヴァ) は、米国のデータゼネラル社からリリースされた一連の16ビット ミニコンピューターのシリーズである。 Novaファミリは1970年代に非常に人気があり、最終的には数万台の個体が販売された。
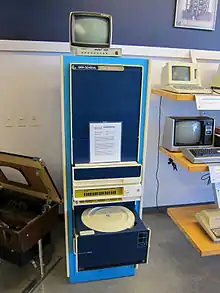
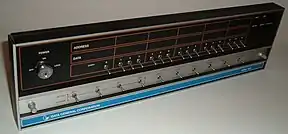
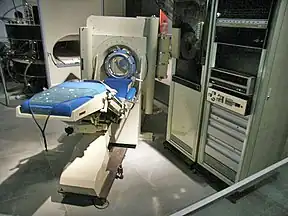
最初のモデルは、単に「Nova」として知られ、1969年にリリースされた。[1] Novaは単一のラックマウントケースに納められ、ほとんどの単純なタスクを処理するのに十分な計算能力を備えていた。 Novaは世界中の科学研究所で人気を博した。 翌年には、約4倍の速度で動作する SuperNOVA が発売された。
集積回路(または「チップ」)設計が急速な進歩していた時期に発売されたこの製品ラインは、その後5年間に何度かのアップグレードを経て、800 と 1200 、Nova 2 、Nova 3 、そして最終的には Nova 4 を発売した。 1チップ実装の microNOVA も1977年に発売されたが、市場が新しいマイクロプロセッサ設計に移行したため、広く使われることはなかった。 フェアチャイルドセミコンダクターも、1977年にNovaのマイクロプロセッサ版であるフェアチャイルド9440を発表したが、これも市場での使用は限定的であった。
Novaシリーズは データゼネラル Eclipse によって継承され、これはほとんどの点で似ていたのだが、仮想メモリのサポートと最新のオペレーティングシステムに必要なその他の機能が追加された。 Eclipse の32ビットアップグレードにより、1980年代の Eclipse MVシリーズ が誕生した。
歴史
エドソン・デ・カストロとPDP-X
エドソン・デ・カストロ (英語版)は、先駆的なディジタル・イクイップメント・コーポレーション (DEC) の PDP-8のプロダクトマネージャで、これは一般的に最初の真のミニコンピュータであると考えられている12ビットコンピュータであった。[2] 彼はまた、個々のトランジスタの代わりに初期の集積回路を使用した、アップグレードされた PDP-8/I の設計を主導した。[3]
PDP-8/I の設計プロセスで、デ・カストロは、組み立て可能な基板の複雑さが急速に進歩している回路基板メーカーを訪問していた。 デ・カストロは、8/Iは、1年前には不可能だったろう大型基板への完全自動組み立てで生産できると結論付けた。 DEC社内の人たちは、以前のマシンで使用されていたより小さな基板に慣れてしまい、1枚の基板上に多くの部品がある場合の問題の追跡を心配していた。[注釈 1] 8/Iについては、密度をわずかに向上させるために新しい「フリップチップ」パッケージを使用して、より小さな基板を使用することに決定した。[3]
PDP-8が開発されていた時期には、1967年に ASCII が導入され、大幅に更新されたことで、それまでのほとんどの設計のように6ビットの倍数ではなく、8ビットの倍数の語長を持つ新世代の設計が登場した。これにより、現在のDECの12ビットや18ビットのラインナップではなく、16ビットの語長で動作するミッドレンジのデザインが設計されるようになった。デ・カストロは、15インチの正方形の基板1枚に16ビットのミニコンピューターCPUを搭載することで、PDP-8の改良が可能であると確信していた。[4] [5]
1967年、デ・カストロは、「PDP-X」として知られる新しい設計作業を開始し。いくつかの先進的な機能が盛り込まれた。これらの中には、8ビット、16ビット、および32ビットのプラットフォームを構築するために使用できる単一の基本設計が含まれていた。[6] これは、いくつかの詳細なアーキテクチャ・ドキュメントを作成するところまで進んだ。 ケン・オルセンは、12ビットのPDP-8や18ビットのPDP-9に比べて十分な利点が得られないと感じ、このプロジェクトを支持しなかった。結局、このプロジェクトは1968年の春に中止された。 [4]
Novaの設計
PDP-Xがキャンセルされたことで、デ・カストロは自分でシステムを作るためにDECを辞めることを検討することになった。彼だけではなかった。 1967年末、志を同じくする技術者たちのグループが、そのようなマシンを検討するために結成された。このグループには、事業部長のパット・グリーン、ハードウェア技術者のリチャード・ソッジ、ソフトウェア技術者のヘンリー・ブルクハートII世が含まれていた。 PDP-Xとは対照的に、この新しい取り組みは、迅速に市場に投入できる単一のマシンに焦点を当てたもので、デ・カストロはPDP-Xのコンセプトは小規模なベンチャー企業には野心的すぎると感じていた。[7]
DECの仲間と話し合った結果、当初の構想では8ビット機の方がコストがかからないということになっていた。[8] この頃、DECとの接点で知り合ったフェアチャイルドセミコンダクターの営業マン、ハーバート・リッチマンに話を聞くようになった。 リッチマンは、機械の内部語長は外部表示と同じである必要はないと指摘した。たとえば、4ビット算術論理演算ユニット (ALU)を使用する16ビット機を使用できる。これは、当時フェアチャイルドが74174という形で発表していた最新のICで安価に実装することができた。 [9]
このアプローチにより、メインロジックの複雑さとコストが大幅に削減され、Novaの低販売コストを実現した。[5] この新しい設計では、1980年代のRISCデザインに再登場するシンプルなロードストアアーキテクチャ[4]が採用された。フリップフロップの複雑さがチップに実装されるにつれて急激に減少していたため、同様の低価格製品に見られる単一レジスタではなく、4つの汎用アキュムレータを追加することで、ロード/ストア設計のアドレッシングモードの不足を補った。[4]
8/I のオリジナルのパッケージコンセプトに沿って、Novaは2枚の15 by 15インチ (38 cm × 38 cm) のプリント回路基板をベースにしている。1つはCPU用で、もう1つはさまざまなサポートシステム用である。 これらの基板は、プリント回路のバックプレーンを使用して接続できるように設計されており、手作業での配線は最小限に抑えられ、すべての基板を自動で構築することができた。 これにより、バックプレーンで一緒に配線しなければならない多くの小さな基板で構成されていた 8/I に比べて、コストを大幅に削減することができた。 また、基板の大型化により、Novaはより信頼性が高くなり、産業用や研究室の環境で特に魅力的な製品となった。 フェアチャイルド社は、システム全体で使用される中規模集積回路 (MSI)チップを提供した。
Nova発売
1967年後半、リッチマンはニューヨークに拠点を置く弁護士のフレッド・アドラーにグループを紹介し、アドラーはシードキャピタルのため様々な資金調達先の聞き込みをはじめた。 1968年までに、アドラーはボストン地域のベンチャーキャピタルのコンソーシアムと大規模な資金調達の契約を結び、彼らは最初に40万ドルの投資を行い、生産を開始するために40万ドルを提供することに同意した。 デ・カストロ、ブルクハート、ソッジはDECを辞め、1968年4月15日にデータジェネラル (DG)を設立した。グリーンは、この事業はリスクが高すぎると考えて参加せず、リッチマンはその年の後半に製品が稼働するまで参加しなかった。 [5]
最初のシステムの開発には約9カ月を要し、最初の販売活動はその11月に開始された。 秋のコンピュータ連合会議がその年の12月まで延期されていたため、彼らは少し幸運にも モスコーニ・センターに開発機を持ち込むことができ、そこで「Spacewar!」のバージョンを実行した。[10] DGは1969年にNovaを基本価格3,995ドルで正式に発売し、「世界最高の小型コンピューター」と宣伝した。 [11] 基本モデルは箱から出してもあまり役に立たず、コアメモリの形でRAMを追加すると、価格は通常7,995ドルになった。[12]
最初の販売先はテキサス州の大学で、チームが手作りした機械が2月に出荷された。しかし、このときは航空業界のストライキのまっただ中で、機械は一向にとどかなかった。ストライキが終わった後に2台目を送ったが、5月になってようやくオリジナルのものが納入された。[13]
このシステムは当初から成功しており、半年後には100台[14]、15カ月後には500台が販売された[12]。 新しいバージョンが登場すれるにつれて販売は加速し、1975年には同社の年間売上高が1億ドルに達した。 [15]
SuperNOVA
ケン・オルセンは、DGが失敗すると公言していたが、Novaのリリースでそれが起こらないことは明らかになった。この時までには、他の多くの企業も16ビット機の導入を検討していた。オルセンは、12ビットだけでなく18ビットのラインにも脅威を与えると判断し、新たな16ビットの設計作業を開始した。 [16] これは1970年にPDP-11として登場したもので[16]、PDP-Xと同様にNovaとは異なる、より複雑な設計であった。この2つの設計は、市場で激しい競争を繰り広げた。 [4]
DECからの新システムの噂は、Novaが出荷を開始して間もなくDGに届いた。 1970年の春、DGは新しい設計者ラリー・セリグマンを雇い、製造中のあらゆる機械を飛躍させた。 Novaの設計以降、2つの大きな変更が行われた。 1つは、ICの改良と高密度化が進んでいたこと、もう1つは、 Intelが半導体ベースのメモリを積極的にアピールしていたことで、1チップで1,000ビットでコアよりもはるかに高速に動作することを約束していたことである。 [16]
セリグマンの新しいデザインは、これらの改善点の両方を利用した。 まず、新しいICによりALUを完全な16ビット幅に拡張し、1サイクルで操作を実行できるようにしたことで、新しいデザインはオリジナルの4倍の計算速度を実現した。 さらに、新しい小型コアメモリが使用され、サイクルタイムがオリジナルの1,200ナノ秒から800ナノ秒に改善され、さらに1/3のゲインを得ることができた。 コアをリード・オンリー・メモリ (ROM) に置き換えることで、性能をさらに向上させることができた。 コアの読み取り/書き込みサイクルがないため、300ナノ秒でアクセスして性能を劇的に向上させることができた。[14]
その結果、1970年に発売されたのが SuperNOVA である。初期型はまだコアを使用していたが、全体の設計は、より高速な半導体メモリが利用できるようになり、プラットフォームはそれをフルに活用できるようになることを前提にしていた。これは、同年後半に半導体(SC)メモリを搭載した SuperNOVA SC として発表された。メモリが大幅に高性能化されたことで、メモリと同期していたCPUがさらに高速化され、サイクルタイム300ナノ秒(3.3MHz)で動作するようになった。これにより、長年にわたり入手可能なミニコンピュータの中では最速のものとなった。 [17] しかし、この新しいメモリも非常に高価で、熱を帯びるため、広く使われることはなかった。[18]
1200 と 800
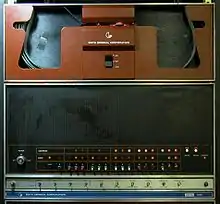
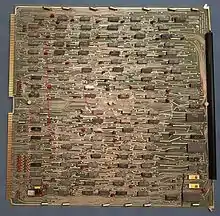
セリグマンが SuperNOVA に取り組んでいたとき、会社はロン・グルナーから「あなたの製品について読んだし、広告も読んだし、あなたのために働くことになった」と書かれた手紙を受け取った。 そして、「一週間後にあなたのオフィスに来て、そのことについて話すつもりである。」と書かれていた。[19] 彼はその場で採用された。
この時点までに、同社は市場の変化を利用するために低価格プラットフォームの新バージョンが必要だと判断し、低価格システムから高性能システムに移行する必要があれば、顧客が現場で1台の機械を交換できるという新しいコンセプトが生まれた。グルナーは低コストの機械を担当し、セリグマンはそれに見合った高性能バージョンを設計した。 [19]
グルナーの低価格モデルは、1970年に Nova 1200 として発売され、1200 はオリジナルのNovaの1,200ナノ秒コアメモリの使用を指している。 また、オリジナルの4ビットALUを使用しており、本質的には再パッケージされたNovaであった。 セリグマンの再パッケージされた SuperNOVA は、Nova 800として1971年にリリースされ、その結果、番号が小さいモデルの方が高性能であるという、やや紛らわしいネーミングになった。 [19]どちらのモデルも様々な筐体で提供され、1200 は7スロット、1210 は4スロット、1220 は14スロットである。
後のモデル
この頃になると、PDP-11がついに出荷された。 PDP-11は、Novaのように意図的に単純化された命令セットよりも、はるかに豊富な命令セットのアーキテクチャを提供していた。 ICの設計、特に価格性能比の向上は、当初の単純化された命令の価値を低下させていた。セリグマンは、Novaと互換性がありながらも、より豊かな環境を求める人のために、新しい機械の設計を担当することになった。このコンセプトは、 データゼネラル Eclipse シリーズとして出荷された。Eclipse は、科学計算またはデータ処理のワークロードに合わせて命令セットを調整するために追加の回路を追加する機能を提供した。 Eclipseは、市場のハイエンドで PDP-11と競争することに成功した。 [20]
同じ頃、DECから新しい32ビット機の噂が流れ始めた。 同じような製品が必要だと判断したDGは、グルナー氏にファウンテンヘッド・プロジェクトの責任者を任せることにした。 プロジェクトの範囲を考えると、彼らはすべての作業をオフサイトで処理することに合意し、グルーナーはノースカロライナ州 のリサーチトライアングルパークの場所を選択した。 この設計は非常に複雑なものとなり[21] 、最終的には数年後に中止となった。
これらの努力が行われている間、Novaラインの作業は続けられた。
840
1973年に初めて提供された 840 は、最大17ビットのアドレスを可能にする新しいページングメモリシステムを搭載していた。 インデックスがベースアドレスをオフセットして128 k語の大容量メモリを搭載した。 実際にこれだけのメモリを搭載するには、かなりのスペースが必要で、840 は14スロットの大型筐体に収められて出荷された。
Nova 2
次のバージョンは Nova 2 で、最初のバージョンは1973年に出荷された。 Nova 2は、チップ密度を上げることでCPUを小型化したため、基本的には初期の機械を簡略化したものであった。 SuperNOVA が15x15インチの基板を3枚使ってCPUとメモリを実装していたのに対し、Nova 2はこれらすべてを1つの基板に収めた。 ROMはブートコードを格納するために使用され、「プログラムロード」スイッチを押すとコアにコピーされた。 4 ("2/4")、7、10 ("2/10") スロットを備えたバージョンがあった。
Nova 3
1975年のNova 3では、内蔵スタックへのアクセスを制御するために2つのレジスタが追加された。 また、プロセッサは TTLコンポーネントを使用して再実装され、システムの性能がさらに向上した。 Nova 3には、4スロット(Nova 3/4)と12スロット(Nova 3/12)があった。
Nova 4
データゼネラルは当初、Nova 3をそのラインの最後の製品とし、Nova を新しい Eclipse 機に置き換えることを計画していた。 しかし、継続的な需要があったため、今回は4つの AMD Am2901 ビットスライス ALU に基づく Nova 4 機が開発された。 この機械は最初から Nova 4 と Eclipse S/140 の両方に対応するように設計されており、それぞれ異なるマイクロコードが使用されていた。 浮動小数点コプロセッサも利用可能で、別のスロットを占有していた。 追加オプションとしてメモリマッピングがあり、バンクスイッチングを使用して最大128 k語のメモリにアクセスできるようになっていた。 初期の機械とは異なり、Nova 4 にはフロントパネルコンソールがなく、必要に応じてターミナルを使用してコンソールをエミュレートしていた。
Nova 4には、Nova 4/C、Nova 4/S、Nova 4/Xの3つのバージョンがあった。 Nova 4/Cは、シングルボード実装で、すべてのメモリ(16k語または32k語)を搭載していた。 Nova 4/Sと4/Xは別々のメモリボードを使用していた。 Nova 4/Xでは、オンボードメモリ管理ユニット (MMU)が有効になっており、最大128 k語のメモリを使用することができる(MMUはNova 4/Sにも搭載されていたが、ファームウェアでは無効になっていた)。 4/Sと4/Xには、必要とされる前にメモリから最大2つの命令をフェッチすることで性能を向上させる「プリフェッチャ」が搭載されていた。
microNOVA
データゼネラルは、Novaプロセッサの1チップ実装を microNOVA として一連の製品を生産した。 バスアーキテクチャの変更により速度が大幅に制限され、オリジナルのNovaの約半分の速度になってしまった。 「mN601」プロセッサを搭載したオリジナルの microNOVA は1977年に出荷された。 その後、1979年にはmicroNOVA MP/100 が発売され、CPUを1つのVLSIチップ、mN602に縮小した。 より大きなバージョンも microNOVA MP/200 として提供され、同じ年に出荷された。
microNOVAはその後、PCスタイルのケースに2つのフロッピーディスクを備えた Enterprise として再パッケージされた。 Enterprise は1981年に出荷され、 RDOSを実行していたが、同じ年に IBM PC が導入されたため、他のほとんどの機械はレーダーの下から姿を消してしまった。
Novaの遺産
Nova は ゼロックス Alto (1973)[22] や Apple I (1976) [23] の設計に影響を与え、そのアーキテクチャーはコンピュータービジョン社の CGP(Computervision Graphics Processor)シリーズの基礎となった。 その外観デザインは、 MITS Altair (1975)マイクロコンピューターのフロントパネルに直接インスピレーションを与えたと報告されている。
データゼネラルは、初代Novaの成功を受けて、一連のより高速な設計ラインで追従した。 その後、上位互換性のある命令セットを拡張した Eclipse ファミリーが導入され、MVシリーズはさらに Eclipse を32ビットアーキテクチャに拡張して DEC VAX に対抗した。 MVシリーズの開発は、トレイシー・キダーの人気の高い1981年の著書「超マシン誕生」に記録されている。 データゼネラル自体は、後にIntelプロセッサベースのサーバーおよびストレージアレイのベンダーへと発展し、最終的にはEMCに買収された。
2004年現在でも、航空管制を含む世界中のさまざまなアプリケーションで16ビットの Nova と Eclipse が稼働している 。世界中には、レガシーな16ビットデータゼネラルシステムを復元して保存する、多様で熱心な人々のグループが存在する 。
技術的な説明
プロセッサ設計
| Data General Nova レジスタ | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
PDP-8とは異なり、Novaはロードストアアーキテクチャであった。 4つの16ビットアキュムレータレジスタを持ち、そのうち2つ(2と3)はインデックスレジスタとして使用できる。 15ビットのプログラム・カウンタと1ビットのキャリー・レジスタがある。 PDP-8と同様に、カレント+ゼロページのアドレス指定が中心となっていた。 スタックレジスタはなかったが、後のEclipseの設計では、この機能のために専用のハードウェアメモリアドレスが使用されるようになった。
Novaの初期のモデルは、1個の 74181 ビットスライス ALUを使用して、4ビットパケットで数値をシリアルに処理していた。 導入から1年後、この設計は改良され、4つの74181を使用した16ビット並列演算ユニットを含むように改良され、この設計は SuperNova と呼ばれるようになった。 システムの将来バージョンでは、スタックユニットとハードウェア乗算/除算が追加された。
Nova 4 / Eclipse S/140 は、4つの AMD 2901 ビットスライスALUをベースにしており、 リード・オンリー・メモリー (ROM) に マイクロコードを搭載し、磁気コアメモリを搭載せず、DRAMメインメモリのみで設計された最初のNovaであった。
メモリとI/O
最初のモデルは、8K語の磁気コアメモリがオプションとして用意されていたが、これは実質的に誰もが購入しなければならなもので、システムコストは最大7,995ドルになった。
このコアメモリ基板は、4つのバンクを4つのグループに分けて平面的に構成されており、各バンクは64 x 64マトリクスで2セットのコアが搭載されていた。したがって、64 x 64 = 4096ビット/セット、x 2セットで8,192ビット、x 4バンクで32,768ビット、x 4グループで合計131,072ビットとなり、これを16ビットのマシン語サイズで割ると8,192ワードのメモリを与える。
この8K語メモリ基板のコアは、中央に配置された幅5.25インチ、高さ6.125インチの「ボード・オン・ア・ボード」を占め、保護板で覆われていた。 このコアは、必要なサポートドライバーの読み取り/書き込み/書き換え回路に囲まれていた。 すべてのコアと対応するサポート電子機器は、単一の標準的な15 x 15-インチ (380 mm) の基板に収まっている。このようなコアRAMは、1つの外部拡張ボックスで最大32Kまでサポートできる。 当時、 半導体 ROMはすでに入手可能であり、RAMなしシステム(つまりROMのみを搭載したシステム)は多くの産業現場で人気を博した。 初代Novaは約200 kHzで動作していたが、SuperNova は特殊な半導体メインメモリを使用した場合、最大3MHzで動作するように設計されていた。
バックプレーンとI/O信号が標準化されているため、シンプルで効率的なI/O設計となっており、プログラムされたI/OやデータチャネルデバイスをNovaに接続する際には、競合するマシンと比較してシンプルなものとなっている。 Novaバックプレーンにはワイヤーラップピンがあり、専用のI/Oバス構造に加えて、標準外のコネクタやその他の特殊な用途にも使用できた。
プログラミングモデル
命令フォーマットは、大きく分けて以下の3つの機能に分類される。1)レジスタ間操作、2)メモリ参照、3)入力/出力。 各命令は1語で構成されていた。 レジスタ間操作はRISCに近いビット効率で、レジスタデータを操作する命令は、テストやシフトを実行し、結果の破棄も可能であった。 ハードウェアのオプションとして、整数乗算除算ユニット、 浮動小数点ユニット (単精度および倍精度)、メモリ管理などがあった 。
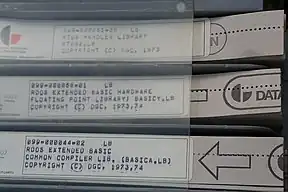
初期のNovaには、 パンチテープの BASICインタプリタが付属していた。 製品が成長するにつれ、データゼネラルはNovaコンピュータ用に多くの言語を開発し、一貫したオペレーティングシステムの下で動作するようになった。 FORTRAN IV 、 ALGOL 、拡張BASIC、データゼネラルBusiness Basic、Interactive COBOL 、およびいくつかのアセンブラがデータゼネラルから提供された。 サードパーティのベンダーやユーザーコミュニティは、 Forth 、 Lisp 、 BCPL 、 C 、 ALGOL 、およびCOBOLとBASICの他の独自バージョンで製品を拡張した。
命令セット
以下に実装されている機械語命令は、Novaシリーズのすべてのプロセッサで共通に実装されているものである。 機種によっては追加の命令が実装されていることが多く、オプションのハードウェアによって提供されている命令もある。
算術命令
すべての算術命令はアキュムレータ間で動作する。 2つのオペランドを必要とする演算では、1つはソース・アキュムレータから、もう1つはディスティネーション・アキュムレータから取り出され、結果はディスティネーション・アキュムレータに格納された。 単一オペランド演算では、オペランドはソース・レジスタから取り出され、結果はデスティネーション・レジスタに置き換わった。 すべての単一オペランド演算では、ソース・アキュムレータとディスティネーション・アキュムレータが同じであることは許容され、演算は期待どおりに機能した。
すべての算術命令には「ノーロード(no-load)」ビットが含まれており、これがセットされると、結果がディスティネーション・レジスタに転送されるのを抑制した。これは、ディスティネーション・レジスタの既存の内容を失うことなくテストを実行するために、テストオプションと組み合わせて使用された。 アセンブリ言語では、オペコードに '#' を追加すると、ノーロード・ビットが設定される。
CPUには、キャリービットと呼ばれる1ビットレジスタがあり、このレジスタは、算術演算の後に最上位ビットのキャリーアウト(桁あふれ)を格納する。 キャリービットは、命令内の2ビットフィールドを使用して演算を実行する前に、必要な値に設定することができる。 ビットは、命令を実行する前にセット、クリア、または補完することができる。 アセンブリ言語では、これらのオプションは、オペコードに文字を追加することによって指定される。 'O' - キャリービットをセット、'Z' - キャリービットをクリア、'C' - キャリービットを補完、何もなし - キャリービットをそのままにする。 ノーロード・ビットも指定された場合、指定したキャリー値が計算に使用されるが、実際のキャリーレジスタは変更されない。
すべての算術命令には、シフトオプションを指定するために使用できる2ビットのフィールドが含まれており、これは結果がディスティネーション・レジスタにロードされる前に適用される。 1ビットの左または右シフトを指定したり、結果の2バイトを入れ替えたりすることができる。 シフトは17ビットの循環で、キャリービットは最上位ビットの「左側」にある。 言い換えれば、左シフトが実行されると、結果の最上位ビットがキャリービットにシフトされ、キャリービットの以前の内容が結果の最下位ビットにシフトされる。 バイトスワップはキャリービットに影響を与えない。 アセンブリ言語では、これらのオプションは、オペコードに文字を追加することによって指定された。 'L' - 左シフト、 'R' - 右シフト、 'S' - バイトスワップ、何もなし - シフトまたはスワップを実行しない。
すべての算術命令には、演算の結果に適用されるテストを指定できる3ビットのフィールドが含まれていた。 テストが真と評価された場合、次の命令はスキップされる。 アセンブリ言語では、テストオプションは命令の第3オペランドとして指定される。 利用可能なテストは次のとおりである:
- SZR - 結果がゼロの場合にスキップ
- SNR - 非ゼロの結果をスキップ
- SZC - ゼロキャリーでスキップ
- SNC - ゼロ以外のキャリーでスキップ
- SBN - キャリーと結果の両方がゼロ以外の場合はスキップ
- SEZ - キャリーまたは結果のどちらか、または両方がゼロの場合はスキップ
- SKP - 常にスキップ
- 何もなし - 決してスキップしない
実際の算術命令は次のようなものである:
- MOV - ソース・アキュムレータの内容をディスティネーション・アキュムレータに移動
- COM - ソース・アキュムレータのビット単位の補数をディスティネーション・アキュムレータに移動
- ADD - ソース・アキュムレータをディスティネーション・アキュムレータに加算
- ADC - ソース・アキュムレータのビット単位の補数を取り、デスティネーション・アキュムレータに加算
- NEG - ソース・アキュムレータの負値をディスティネーション・アキュムレータに移動
- SUB - デスティネーション・アキュムレータからコンテンツ・ソース・アキュムレータを減算
- INC - ソース・アキュムレータの内容に1を加算し、デスティネーション・アキュムレータに移動
- AND - 2つのアキュムレータのビットごとのANDを実行し、結果をディスティネーション・アキュムレータに配置
すべてのオプションを利用した算術命令の例は次のとおり:
ADDZR# 0,2,SNC
これは次のようにデコードされている。キャリービットをクリアし、 AC2(アキュムレータ2)の内容をAC0 に追加し、結果を1ビット右に循環シフトし、結果をテストしてキャリービットが設定されているかどうかを確認し、設定されている場合は次の命令をスキップする。 テストを実行した後、結果を破棄する。 実際には、これは2つの数値を加算し、結果が奇数か偶数かをテストする。
メモリ参照命令
Nova命令セットには、メモリの内容をアキュムレータに転送する命令とその逆の命令のペア、2つの制御転送命令、およびメモリ・ロケーションの内容をテストする2つの命令が含まれている。 すべてのメモリ参照命令には、8ビットのアドレス・フィールドと、メモリ・アドレッシングのモードを指定する2ビットのフィールドが含まれていた。 4つのモードは次のとおりである:
- Mode 0 - 絶対アドレッシング。 命令のアドレス・フィールドの内容は左側がゼロで埋められ、ターゲット・アドレスとして使用されます。
- Mode 1 - 相対アドレッシング。 命令のアドレス・フィールドの内容は、左に符号拡張され、プログラムカウンタの現在値(命令が実行されるまでに次の命令を指します)に加算する。 その結果がターゲット・アドレスとして使用される。
- Mode 2 - インデックス・アドレッシング。 命令のアドレス・フィールドの内容が、左に符号拡張され、アキュムレータ2の現在値に加算される。その結果がターゲット・アドレスとして使用される。
- Mode 3 - インデックス・アドレッシング。 命令のアドレス・フィールドの内容が、左に符号拡張され、アキュムレータ3の現在値に加算される。 その結果がターゲット・アドレスとして使用される。
明らかに、Mode 0は、8ビットのアドレス・フィールドがあるため、最初の256メモリ語だけをアドレス指定できた。 メモリのこの部分は「ページ・ゼロ」と呼ばれていた。 ページ・ゼロのメモリ・ワードは、利用可能な数が少ないため、Novaのアセンブリ言語プログラマにとって貴重なものと考えられていた。ページ・ゼロの場所だけが、インデックスレジスタとして使用するためにアキュムレータ2や3を縛る必要のあるインデックスアドレスに頼ることなく、プログラムのどこからでもアドレスを指定することができた。アセンブリ言語では、".ZREL" ディレクティブにより、アセンブラはそれに続く命令とデータ語をページ・ゼロに配置し、".NREL" ディレクティブにより、それに続く命令とデータ語を「通常の」メモリに配置した。後のNovaモデルでは、アドレス・フィールドを拡張した命令が追加され、この問題を克服した(性能的にはペナルティがある)。
アセンブラは、Mode 1の相対オフセットを自動的に計算するが、ソースに明示的に書き込むことも可能であった。 メモリ参照命令が .NREL 空間のメモリアドレスを参照しているがモード指定子がない場合、Mode 1が想定され、アセンブラは現在の命令と参照されている位置との間のオフセットを計算し、これを命令のアドレス・フィールドに配置した(結果として得られる値が8ビットフィールドに収まる場合)。
2つのロードおよびストア命令は次のとおりである:
- LDA - メモリ位置の内容を指定されたアキュムレータにロードする
- STA - 指定されたアキュムレータの内容をメモリ位置に格納する
これらの命令には両方とも「間接(indirect)」ビットが含まれていた。 このビットがセットされている場合(アセンブリ言語ではオペコードに '@'を追加することで行われる)、ターゲット・アドレスの内容はメモリ・アドレスそのものであると仮定され、ロードまたはストアを行うためにそのアドレスが参照される。
2つの制御転送命令は次のとおりである:
- JMP - 指定されたメモリ位置に制御を移す
- JSR("jump subroutine")- JMP命令と同じであるが、ジャンプする前にリターン・アドレス(JSR命令に続く命令)を追加でアキュムレータ3にロードする
ロードおよびストア命令と同様に、ジャンプ命令には間接ビットが含まれており、同様にアセンブリでは '@' 文字で指定されている。 間接ジャンプの場合、プロセッサはジャンプ先の内容を取得し、その値をジャンプ先のメモリアドレスとして使用する。 ただし、ロードおよびストア命令とは異なり、間接アドレスに最上位ビットがセットされている場合は、さらに1サイクルの間接ジャンプが実行される。 Nova 3より前のNovaシリーズプロセッサでは、間接アドレスの回数に制限はなかった。自分自身を参照する間接アドレスは、命令が完了することなく、無限に間接アドレッシングループが発生する。 (この状態では、フロントパネルのSTOPスイッチを押しても何もしないので、ユーザにとっては不安になるかもしれなかった。ループを解除するには、機械をリセットする必要があった。)
2つのメモリテスト命令は次のとおりである:
- ISZ - メモリ位置をインクリメントし、結果がゼロの場合は次の命令をスキップする
- DSZ - メモリ位置をデクリメントし、結果がゼロの場合は次の命令をスキップする
ロードおよびストア命令の場合と同様に、1レベルの間接アドレス指定を実行する間接ビットがあった。 これらの命令は、磁気コアメモリを搭載したNovaでは、メモリ基板自体の内で命令が実行されるという点で奇妙なものだった。 当時のメモリ基板には、磁気コアメモリに内在する破壊的な読み出し問題を解決するための「ライトバック」回路が搭載されていた。 しかし、ライトバック機構には、ミニ演算ユニットも含まれており、これはプロセッサがいくつかの目的で使用していた。 ISZ命令とDSZ命令では、読み取られたメモリ位置からライトバックが行われるまでの間にインクリメントまたはデクリメントが行われ、CPUは単に結果がゼロか非ゼロかの通知を待つだけであった。 これらの命令は、アキュムレータを拘束することなくメモリ位置をループカウンタとして使用できるため便利であったが、同等の算術命令よりも処理速度が遅くなった。
メモリ参照命令の例:
LDA 1,COUNT
COUNTというラベルのメモリ・ロケーションの内容をアキュムレータ1に転送する。 COUNTが .NREL 空間にあると仮定すると、この命令は次のようになる: LDA 1,1,(COUNT-(.+1))
ここで、'.' はLDA命令の位置を表す。
JSR@ 0,17
ページ・ゼロ空間のロケーション17の内容で指定されたメモリアドレスに間接的にジャンプし、リターンアドレスをアキュムレータ3に格納する。 これは、初期のNovaモデルでRDOSシステムコールを行うための標準的な方法で、アセンブリ言語のニーモニック ".SYSTM" はこれに変換される。
JMP 0,3
アキュムレータ3にアドレスが格納されているメモリ位置にジャンプする。 JSR命令はリターンアドレスをアキュムレーター3に残しているので、これは関数やサブルーチン呼び出しから戻るための一般的な方法であった。
STA 0,3,-1
アキュムレータ0の内容を、アキュムレータ3に含まれるアドレスより1つ少ない位置に格納する。
DSZ COUNT
COUNTというラベルの場所の値をデクリメントし、結果がゼロの場合は次の命令をスキップする。上記の場合と同様に、COUNTが .NREL 空間にあると仮定すると以下のようになる: DSZ 1,(COUNT-(.+1))
I/O命令
Novaは、I/Oデバイスとのインターフェースのためのチャネル化モデルを実装した。 このモデルでは、各I/Oデバイスは、"Busy" および "Done" と呼ばれる2つのフラグと、A, B, Cと呼ばれる3つのデータと制御レジスタを実装することが期待されていた。 I/O命令は、レジスタを読み書きし、"start", "clear", "pulse" と呼ばれる3つの信号のうちの1つをデバイスに送信するために利用可能である。一般的に start 信号を送ると、A/B/Cレジスタに値をロードすることで設定されたI/O動作が開始される。clear 信号はI/O動作を停止し、発生した割り込みをクリアする。pulse 信号は、ディスクドライブのシーク操作など、複雑なサブシステムの付帯操作を開始するために使用された。ポーリングされたデバイスは通常、デバイスとAレジスタの間で直接データを移動した。 DMAデバイスは一般的に、メモリアドレスを指定するためにAレジスタを使用し、転送するワード数を指定するためにBレジスタを使用し、制御フラグをセットするためにCレジスタを使用していた。 チャネル63はCPU自体を参照し、さまざまな特殊機能に使用された。
各I/O命令には、6ビットのチャネル番号フィールド、どのレジスタを読み書きするかを指定する4ビット、どの信号を送信するかを指定する2ビットのフィールドが含まれた。 アセンブリ言語では、信号はオペコードに文字を追加することによって指定された。'S' は start、'C' は clear、'P' は pluse 、信号がない場合は何も指定しない。 オペコードは次のとおりである:
- DIA - デバイスのAレジスタの内容を指定されたアキュムレータに移動
- DOA - 指定されたチャネルのデバイスのAレジスタに指定されたアキュムレータの内容を送信
- DIB - デバイスのBレジスタの内容を指定されたアキュムレータに移動
- DOB - 指定されたチャネルのデバイスのBレジスタに指定されたアキュムレータの内容を送信
- DIC - デバイスのCレジスタの内容を指定されたアキュムレータに移動
- DOC - 指定されたチャネルのデバイスのCレジスタに指定されたアキュムレータの内容を送信
- NIO - "no I/O" の誤記。 この命令は、レジスタ転送を行わずにデバイスに信号を送信するために使用された。
さらに、デバイスの状態をテストするための4つの命令が用意されていた:
- SKPBN - デバイスのBusyフラグが設定されている場合、次の命令をスキップ
- SKPBZ - デバイスのBusyフラグがクリアされている場合、次の命令をスキップ
- SKPDN - デバイスのDoneフラグが設定されている場合、次の命令をスキップ
- SKPDZ - デバイスのDoneフラグがクリアされている場合、次の命令をスキップ
デバイスを起動すると、Busyフラグが設定される。 要求された操作が完了すると、従来はデバイスは Busyフラグをクリアして Doneフラグを設定していたが、ほとんどのデバイスでは、割り込み要求メカニズムが Doneフラグに接続されていたため、Doneフラグを設定すると割り込みが発生する(割り込みが有効でデバイスがマスクされていない場合)。
特殊な命令
これらの命令は、さまざまなCPU制御およびステータス機能を実行した。 これらの命令はすべて、実際にはCPUの自己参照I/Oチャネルであるチャネル63のI/O命令の略記ニーモニックであった。
- INTA - 割り込みアクノリッジ(確認)。 割り込みデバイスのチャネル番号を指定されたアキュムレータに転送
- INTDS - すべての割り込みを無効化
- INTEN - すべての割り込みを有効化
- IORST - I/Oリセット。 I/Oバス上でリセット信号を送信し、すべてのI/Oを停止し、割り込みを無効化し、保留中のすべての割り込みをクリア
- MSKO - マスクアウト。 指定されたアキュムレータの内容を使用して割り込みマスクを設定。 マスクがどのように解釈されるかは、各I/Oデバイスの実装に依存する。 一部のデバイスはマスクできなかった。
- READS - フロントパネルの16個のデータスイッチの内容を指定されたアキュムレータに転送
- HALT - CPUを停止。 一度停止したCPUはフロントパネルで手動で介入することによってのみ再起動させることができた。
割り込みと割り込み処理
ハードウェアの観点から見ると、割り込み機構は比較的単純であったが、現在のCPUアーキテクチャに比べると柔軟性に欠けるものであった。 バックプレーンは、1本の割り込み要求ラインをサポートしており、割り込み要求が可能なデバイスはすべてこのラインに接続されていた。 デバイスが割り込みを要求する必要がある場合は、デバイスはこのラインを立ち上げた。 CPUは、現在の命令を完了するとすぐに割り込みを実行する。 上記のように、デバイスが割り込みを要求した場合は"done"のI/Oフラグを立てることになっており、CPUがそのデバイスのチャネルでI/Oクリア命令を実行すると、デバイスは割り込み要求をクリアすることになっていた。
CPUは、オペレーティングシステムが割り込みサービスルーチンのアドレスをメモリアドレス1に格納することを期待していた。 デバイスが割り込みを行うと、CPUはアドレス1を介して間接的にジャンプし、戻りアドレスをメモリアドレス0に配置して、それ以上の割り込みを無効にした。 次に、割り込みハンドラはINTA命令を実行して、割り込みデバイスのチャネル番号を検出する。 これはバックプレーン上の「アクノリッジ」信号を立ち上げることで動作する。 アクノリッジ信号は、バックプレーン上でデイジーチェーン形式で配線されており、バス上の各基板をループしている。 割り込みを要求するデバイスは、アクノリッジ信号がバスへ伝播するのをブロックして、2つ以上のデバイスが同時に保留中の割り込みを持っていた場合、最初のデバイスだけがアクノリッジ信号を受け取ることができるようにする必要がある。 そのデバイスは、そのチャネル番号をバス上のデータラインに設定することで応答する。 つまり、同時割り込み要求があった場合は、カードケージ内のCPUに物理的に最も近いデバイスが優先されることになる。
割り込みが処理され、サービスルーチンがデバイスにI/Oクリアを送信した後、割り込みを有効にし、メモリアドレス0を介して間接ジャンプして戻ることで、通常の処理を再開した。 リターンジャンプの直前に保留中の割り込みが発生しないように(リターンアドレスが上書きされてしまう)、INTEN命令には1命令サイクルの遅延があった。 これを実行すると、JMP@0命令であるはずの次の命令が実行されるまで割り込みが有効にならなかった。
次に、オペレーティングシステムの割り込みサービスルーチンは、通常、受信したチャネル番号を使用してインデックス・ジャンプを実行し、そのデバイスの特定の割り込み処理ルーチンにジャンプする。 特にCPUの電源障害検出回路のように、INTA命令に反応しないデバイスもあった。 INTAがゼロの結果を返した場合、割り込みサービスルーチンは、どのデバイスが割り込みを行ったかを確認するためにSKPDZ / SKPDN命令を使用してINTAに応答しないデバイスをすべてポーリングしなければならなかった。
オペレーティングシステムは、MSKO命令を使用して割り込みマスクを設定することで、割り込みの順序をある程度管理することができる。 これは、ある特定の時間にどのデバイスが割り込みを許可されているかをオペレーティングシステムが判断できるようにするためのものである。 この命令が発行されると、バックプレーン上のすべてのデバイスに16ビットの割り込みマスクが送信された。 マスクが実際に何を意味するかを決定するのはデバイス次第であった。慣例により、マスクアウトされたデバイスは割り込みラインを立ち上げてはいけないとされていたが、CPUはこれを強制する手段を持っていなかった。 マスク可能なデバイスの多くは、基板上のジャンパーでマスクビットを選択できるようになっていた。 マスクを完全に無視するデバイスもあった。
磁気コアメモリ(電源がなくても内容を保持する)を備えたシステムでは、電源障害からの回復が可能であった。 コンピュータの主電源の喪失を検出すると、CPU内の停電検出回路が割り込みを発行し、その時点から電源装置のコンデンサが充電されなくなってCPUへの電力供給が停止するまでにCPUには少し時間があった。 これは、IORST命令を発行して進行中のI/Oを停止し、4つのアキュムレータの内容とキャリービットをメモリに保存するのに十分な時間であった。 電源が回復したときに、CPUのフロントパネルのキースイッチがLOCK位置にあれば、CPUは起動してメモリアドレス2を経由して間接ジャンプを行う。 これは、アキュムレータとキャリービットを再ロードし、その後、通常の処理を再開するオペレーティングシステムのサービスルーチンのアドレスであると予想されていた。 電源障害によって中断されたI/O操作をどのようにして再開するかは、サービスルーチンにかかっていた。
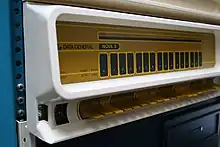
フロントパネルのレイアウト
当時の慣習として、ほとんどのNovaモデルには、CPU機能を制御したり監視するためのフロントパネルコンソールが装備されていた。 Nova 3より前のモデルでは、上記のNova 840パネル写真のような標準的なフロントパネルレイアウトが採用されていた。 このレイアウトには、キー付き電源スイッチ、2列のアドレスランプとデータ表示ランプ、1列のデータ入力スイッチ、および押すとさまざまなCPU機能を作動させるファンクションスイッチが含まれていた。 アドレスランプは常にプログラムカウンタの現在値をバイナリで表示していた。 データ表示ランプは、その時点でどのCPU機能が作動しているかによってさまざまな値を表示していた。 一番左のデータランプの左側には、キャリービットの現在値を表示するランプが追加されていた。 ほとんどのモデルでは、ランプは白熱電球で、パネルボードにはんだ付けされていた。切れたランプを交換することは、データゼネラルのフィールドサービスエンジニアにとって悩みの種であった。
各データスイッチは16ビット値の1ビットの値を制御し、データゼネラルの慣習に従って、左から右へ0〜15の番号が付けられていた。 データスイッチは、さまざまな機能のためのCPUに入力を提供し、READSアセンブリ言語命令を使用して実行中のプログラムから読み出すこともできる。 パネルの乱雑さを減らしてコスト削減のために、ファンクションスイッチは双方向のモーメンタリスイッチとして実装された。 ファンクションスイッチのレバーを上げると、パネル上のスイッチの上に記載されている名前の機能が作動し、レバーを押し下げると、スイッチの下に表示されている名前の機能が作動する。 スイッチレバーを離すと中立位置に戻った。
Nova 840の写真を参照すると、左から最初の4つのスイッチが4つのアキュムレータのEXAMINEとDEPOSIT機能を実行する。 これらのうちの1つでEXAMINEを押すと、アキュムレータの現在値がデータランプに二進数で表示された。 DEPOSITを押すと、データスイッチに現在設定された二進数値がアキュムレータに転送された。
右に進むと、次のスイッチはRESET/STOPスイッチであった。 STOPを押すと、CPUは現在の命令の完了後に停止する。 RESETを押すと、CPUは直ちに停止し、CPU内部レジスタをいくつかクリアし、接続されているすべてのデバイスにI/Oリセット信号を送信する。 その右側のスイッチがSTART/CONTINUEスイッチである。 CONTINUEを押すと、CPUは現在プログラムカウンタが指し示している命令の実行を再開する。 STARTを押すと、現在データスイッチ1〜15に設定されている値がプログラムカウンタに転送され、そこから実行が開始された。
次の2つのスイッチは、フロントパネルからのメモリの読み出しと書き込みを行う。 EXAMINEを押すと、データスイッチ1〜15に設定されている値がプログラムカウンタに転送され、対応するメモリに値が取り込まれ、その値がデータランプに表示される。 EXAMINE NEXTを押すと、プログラムカウンタの値がインクリメントされ、そのメモリ位置の検査操作が行われ、ユーザーは一連のメモリ位置をステップ実行できる。 DEPOSITを押すと、データスイッチに含まれている値がプログラムカウンタが指すメモリ位置に書き込まれる。 DEPOSIT NEXTを押すと、最初にプログラムカウンタがインクリメントされ、次にポイントされたメモリ位置に書き込まれた。
INST STEP機能により、CPUは現在のプログラムカウンタの位置で1つの命令を実行した後、停止した。 プログラムカウンタは命令実行の一部としてインクリメントされるため、これにより、ユーザはプログラムをシングルステップで実行することができた。 MEMORY STEPは誤記で、CPUは1クロックサイクルを実行して停止した。 これはユーザにとってはほとんど意味がなく、通常はフィールドサービス担当者が診断のためにのみ使用した。
PROGRAM LOADは、通常Novaの起動に使用されるメカニズムであった。 このスイッチがトリガーされると、32語のブートROMがメモリの最初の32語にマッピングされ、プログラムカウンタを0に設定して、CPUを起動した。 ブートROMには、選択されたI/Oデバイスから256語(512バイト)のコードをメモリに読み出し、次に読み出したコードに制御を移すコードが含まれていた。 データスイッチ8〜15は、ブートROMにどのI/Oチャネルからブートするかを指示するために使用された。 スイッチ0がオフの場合、ブートROMはデバイスをポーリングされたデバイス(たとえば、紙テープリーダー)であるとみなし、512バイトが読み込まれるまでポーリングされた入力ループを実行した。 スイッチ0がオンの場合、ブートROMはデバイスがDMA対応デバイスであると仮定し、DMAデータ転送を開始した。 ブートROMは、転送を開始する前にデバイスを配置するのに十分な賢さを持っていなかった。 これは、クラッシュ後の再起動時に問題となった。ブートデバイスがディスクドライブの場合、そのヘッドがランダムなシリンダーに残されていた可能性があった。 ブートシーケンスを動作させるには、RDOSが第1レベルのブートブロックを書き込んだシリンダ0に再配置する必要があった。 従来は、ドライブのロードシーケンスを循環させることで行われていたが、待ち時間(ドライブのモデルによっては最大5分)に不満を感じていたユーザは、フロントパネルからドライブの「再調整」I/Oコードを入力し、それをCPUにシングルステップで実行させる方法を学んだ。これは、経験豊富なユーザが数秒で完了した操作である。
電源スイッチは、OFF、ON、LOCKと書かれた3方向キースイッチであった。 OFFポジションでは、CPUからすべての電源が遮断されていた。 キーをONにすると、CPUに電源が供給された。 ただし、現在のCPUとは異なり、電源投入時にCPUが自動的に起動するわけではなく、ユーザは、PROGRAM LOADまたはその他の方法を使用してCPUを起動し、ブートシーケンスを開始する必要があった。 スイッチをLOCKにすると、フロントパネルのファンクションスイッチが無効になるため、スイッチをLOCKにしてキーを外すことで、CPUを改ざんされにくい状態にすることができた。また、磁気コアメモリを搭載しているシステムでは、LOCK状態にすることで自動停電復旧電機能が有効になった。 キーは OFFまたはLOCKポジションで取り外すことができた。
アセンブリ言語の例
Hello world プログラム
これは、Novaアセンブリ言語による最小限のプログラミング例である。 RDOSで実行するように設計されており、コンソールに "Hello, world." という文字列を出力する。
  ; a "hello, world" program for Nova running RDOS
  ; uses PCHAR system call
  .titl hello
  .nrel
  .ent start

 start:
 dochar:
  lda  0,@pmsg ; load ac0 with next character,
  mov#  0,0,snr ; test ac0; skip if nonzero (don't load result)
  jmp  done
  .systm
  .pchar     ; print first
  jmp  er    ; skipped if OK
  movs  0,0   ; swap bytes
  .systm
  .pchar     ; print second
  jmp  er    ; skipped if OK
  isz  pmsg   ; point to next character
  jmp  dochar  ; go around again

 done:
  .systm     ; normal exit
  .rtn
 er:
  .systm     ; error exit
  .ertn
  halt

 pmsg:
  .+1       ; pointer to first character of string
          ; note bytes are packed right-to-left by default
          ; <15><12> denotes a CR LF pair.
  .txt /Hello, world.<15><12>/
  0        ; flag word to end string

  .end start
16ビット乗算
Novaの基本モデルには、価格競争力を維持するためにハードウェアの乗算/除算機能が内蔵されていなかった。 次のルーチンは、2つの16ビット語を乗算して 16ビット語の結果を生成する(オーバーフローは無視される)。 これは、ALU 命令の shift および test(スキップ)を組み合わせて使用していることを示している。 このルーチンが jsr によって呼び出された場合、AC3はリターン・アドレスを保持していることに注意すること。 これはリターン命令 jmp 0,3 によって使用される。 アキュムレータをクリアする慣用的な方法は sub 0,0 である。 他の単一命令は、有用な定数の特定のセット(たとえば、-2、-1、または+1)をロードするように配置することができる。
 mpy:	; multiply AC0 <- AC1 * AC2, by Toby Thain

 	sub 0,0		; clear result
 mbit:	movzr 1,1,szc	; shift multiplier, test lsb
 	add 2,0		; 1: add multiplicand
 	movzl 2,2,szr	; shift and test for zero
 	jmp mbit	; not zero, do another bit
 	jmp 0,3		; return
2進印刷演算器
次のルーチンは、16桁の2進数としてAC1の値をRDOSコンソールに出力する。 これは、Nova命令セットのさらなる奇抜さを明らかにしている。 たとえば、任意の「即時」値("immediate value")をアキュムレータにロードする命令はない(ただし、メモリ参照命令はそのような値をエンコードして実効アドレスを形成する)。 アキュムレータは一般に、初期化されたメモリ位置(例: n16 )からロードしなければならない。 PDP-11などの他の最新のマシンや、事実上のすべての最新アーキテクチャでは、即時ロードが可能であるが、 ARMなどの多くのマシンでは、即時ロードできる値の範囲が制限されている。
RDOSの .systm 呼び出しマクロは jsr を実装しているため、AC3は .pchar 関数の戻りアドレスで上書きされる。 したがって、この関数の呼び出し元の戻りアドレスを保持するための一時的な場所が必要になる。 再帰的なルーチンや再入可能なルーチンの場合は、スタック、利用可能な場合はハードウェア、利用できない場合はソフトウェアを代わりに使用しなければならない。 リターン命令は jmp @ retrn となり、Novaの間接アドレッシングモードを利用してリターンPCをロードする。
末尾の定数定義では、2つのアセンブラ機能を示している。アセンブラの基数はデフォルトで8進数 ( 20 = 10進数の16)で、文字定数は "0" などのようにエンコードすることができる 。
 pbin: ; print AC1 on console as 16 binary digits, by Toby Thain

    sta   3,retrn   ; save return addr
    lda   2,n16    ; set up bit counter
 loop: lda   0,chr0   ; load ASCII '0'
    movzl  1,1,szc   ; get next bit in carry
    inc   0,0     ; bump to '1'
    .systm
    .pchar       ; AC0-2 preserved
    jmp   err     ; if error
    inc   2,2,szr   ; bump counter
    jmp   loop    ; loop again if not zero
    lda   0,spc    ; output a space
    .systm
    .pchar
    jmp   err     ; if error
    jmp   @retrn

 spc:  " ;that's a space
 chr0: "0
 n16:  -20
 retrn: 0
事実
モントリオールのカナダ放送協会では、1980年代後半までチャンネル再生の自動化にNova 1200を使用していた。 その後、改装されたNova 4ユニットに置き換えられ、1990年代半ばまで使用されていた。
関連
- フェアチャイルド9440 - Nova 2と3の1チップ実装
- National Semiconductor IMP-16 - オリジナルのNovaの5チップp-mos実装
- ナショナルセミコンダクターPACEとINS8900 - 単純化された命令セットを備えた1チップ実装
参考文献
引用
- “Computer History Museum - Data General Corporation (DG) - The Best Small Computer in the World”. 2020年6月28日閲覧。
- Hey, Tony; Hey, Anthony; Pápay, Gyuri (2014). The Computing Universe: A Journey through a Revolution. p. 165. ISBN 9780521766456
- Hendrie 2002, p. 40.
- Supnik 2004.
- Hendrie 2002, p. 48.
- Hendrie 2002, p. 42.
- Hendrie 2002, p. 43.
- Hendrie 2002, p. 43-44.
- Hendrie 2002, p. 44.
- Hendrie 2002, p. 49.
- “The best small computer in the world” (1968年11月). 2020年6月28日閲覧。
- “Thwarted at DEC, Thriving at Data General”. Computer History Museum. 2020年6月28日閲覧。
- Hendrie 2002, p. 50.
- “SUPER NOVA”. Computer History Museum (1970年). 2020年6月28日閲覧。
- “The Business That Time Forgot Data General is gone. But does that make its founder a failure?”. money.cnn.com (2003年4月1日). 2016年7月27日閲覧。
- Hendrie 2002, p. 53.
- “Data General History / Background”. Clemson University. 2020年6月28日閲覧。
- Hendrie 2002, p. 54.
- Hendrie 2002, p. 55.
- Hendrie 2002, p. 58.
- Hendrie 2002, p. 60.
- Charles P. Thacker (1974年12月). “Alto: A Personal Computer System”. p. 13. 2020年6月28日閲覧。
- Tom Owad (2005). Apple I Replica Creation: Back to the Garage. p. xxi. ISBN 1-931836-40-X
- Technical Manual Nova 1200, Data General 015-000002, 1971, p.1-4
- Eclipse MV/6000 Principles of Operation, Data General 014-000648, 1980, App. F
参考文献
- Hendrie, Gardner (2002年11月22日). "Oral History of Edson (Ed) D. de Castro" (PDF) (Interview).
- Supnik, Bob (2004年1月10日). "What Was The PDP-X?" (PDF). 2020年6月28日閲覧。
外部リンク
- Bob SupnikのSimHプロジェクト –ユーザが変更可能なパッケージに基本的なNovaエミュレーターが含まれている
- The Portable C Compilerには、NOVAターゲットが含まれている
- Novas Are Forever(SimuLogic's)website – DGのすべてをアーカイブ化し、無料の製品と商用製品を提供しようとしている
- ポータブルPDP-8とDG Novaクロスアセンブラ
- Carl Friend's Minicomputer Museum – Novaの命令セットを詳しく説明している