ベルマン方程式
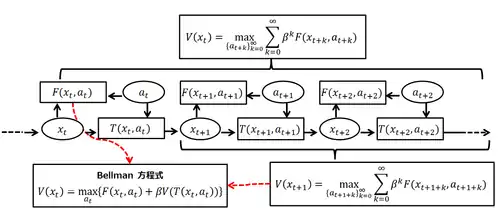
ベルマン方程式(ベルマンほうていしき、英: Bellman equation)は、動的計画法(dynamic programming)として知られる数学的最適化において、最適性の必要条件を表す方程式であり、発見者のリチャード・ベルマンにちなんで命名された。動的計画方程式 (dynamic programming equation)とも呼ばれる。 ベルマン方程式は、決定問題(decision problem)において、ある時刻の初期選択と、それ以降の決定問題の価値との関係を記述する。これにより、動的な最適化問題を、ベルマンの最適性の原理が示す指針にしたがって、より単純な部分問題(subproblems)に分解するのである。
ベルマン方程式は最初、制御工学や他の応用数学上の問題に適用され、その後、経済理論(economic theory)における重要なツールとなった。しかしながら、動的計画法の基本概念はもともとジョン・フォン・ノイマンとオスカー・モルゲンシュテルンのゲーム理論と経済活動 やエイブラハム・ウォールドの 時系列解析(sequential analysis) の研究の中で次第に形作られてきたものである。
最適制御理論で解かれるほとんどの問題は、適切なベルマン方程式を用いて解くことができる。 ただし、一般に「ベルマン方程式」という用語は離散時間の最適化問題を解く際に用いられる動的計画法の方程式を指す。 連続時間の最適化問題を解く場合には、ベルマン方程式の連続時間形式である偏微分方程式を用い、これをハミルトン-ヤコビ-ベルマン方程式と呼ぶ。
動的計画法の考え方
ベルマン方程式を理解するには、いくつかの背景となる概念を理解しなくてはならない。 第一に、最適化問題は何らかの目標を持つ。具体例を挙げれば、移動時間を最短にする、コストを最小に抑える、利益を最大化する、効用を最大化する、などである。これらの目標を数学の関数で表現したものを 目的関数 (objective function) と呼ぶ。
動的計画法は複数段階にわたる計画問題を、各時点の簡単な手順へと分解する。そのため、ある時点でなされた決定がそれ以降どのように影響を及ぼすか正しく記述しなくてはならない。正しい判断を下すために必要な現在の状況を示す情報を 状態 (state) と呼ぶ[1][2]。例えば、人がある時点で何をどれだけ消費するか決めるには、(何よりもまず)現在の富(資産額)を知らなくてはならない。 そのゆえ、富は、経済活動を行う人が持つ状態変数の一つと考えられる。言うまでもなく、このような状態変数は他にも存在する。
任意の時点で選ぶことのできる変数を通常 制御変数 (control variables) と呼ぶ。 例えば、人々は与えられた富のもとで、どれだけ消費すべきか判断する。制御変数を選ぶことは、次の状態を選択することでもある。ただし、一般に次の状態は制御変数だけではなく他の要因によっても影響を受ける。具体例で示そう。最も単純には、今日の富(状態)と消費(制御変数)によって明日の富(次の状態)が決まる。だが、多くの場合、明日の富には別の要因(例:予期せぬボーナス、天災など)も影響するであろう。
動的計画法は、与えられたどんな状態に対しても、適切な制御の指針を与えるような最適な計画を記述する。一例として、消費 が富 だけに依存する場合には、我々は、財産の関数として消費を決定するような制御則 を探索することになる。 状態に基づいて制御変数を決定するこのような関数を、方策関数 (policy function)(Bellman、1957、Ch. III.2を参照)と呼ぶ[1]。


最後に、最適な決定ルール(制御則)はその定義から、実現可能な最良の目的関数の値をもたらすものである。例えば、ある人が与えられた富のもと、満足度を最大化するための消費活動を選ぶとしよう。ただし、満足度 は効用関数(utility function)のような目的関数で表現できるとする。この時、各時刻の財産はそれで実現可能な満足度の最大値 と関係付けることができる。ある状態で実現しうる最良の目的関数の値を示す関数を 価値関数 (value function) と呼ぶ。


リチャード・ベルマンは、離散時間形式の動的最適化問題が、ある時刻の価値関数とその次の時刻の価値関数の間の関係式を書き下すことによって、再帰的な、後ろ向き帰納法(backward induction)と呼ばれる逐次的な形式で表現できることを示した。上述の時間的に隣接する二つの価値関数の関係式がベルマン方程式である。このアプローチでは、終端時刻における最適な方策は、その時刻の状態変数の関数としてすでに決まっており、結果として得られる目的関数の最適値は状態変数で与えられる。次に、最後から一つ前の時刻の最適化を考えると、決定に際して、その状態変数に付随する最適な方策のもとで、その時刻の目的関数と未来の目的関数の和を最大化する。このアルゴリズムは、再帰的に時間を遡る形で進み、初期時刻において、初期状態の関数としての決定ルールが初期時刻に固有の目的関数と2番目のステップの価値関数(第2ステップ以降すべての未来の価値)の和の最適化計算によって得られるまで繰り返される。ゆえに、各ステップにおける決定は、それ以降の未来すべての判断が最適である事を前提として行われるのである。
ベルマン方程式の導出
動的決定問題
時刻 における状態を とする。時刻0から始まる決定問題において、初期状態 は与えられているものとする。任意の時間において、選択可能なアクションはその時の状態の関数であり、 と表すことができる。 は一つ以上の制御変数を表している。アクション が選ばれると、それによって状態は から新しい状態 へと変化するものとする。さらに、状態 においてアクション をとった時の損得を で表す。最後に、我々は性急さ(せっかちさ)[3]の度合いが、割引率(discount factor) で表されるものとする。


これらの仮定の下で、無限の未来までを考慮した決定問題(無限期間の最適化問題) は次式となる。
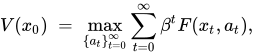
ただし次の条件のもとで:
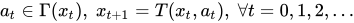
想定された拘束条件のもとで目的関数を最適化した結果としての、最適な値を表現するものとして を定義したことに注意しよう。この関数を価値関数 (value function)と呼ぶ。最適値は初期状態によって変化するから、価値関数 は初期状態 の関数となる。

ベルマンの最適性の原理
動的計画法は、この決定問題をより小さな部分問題に分割する。リチャード・ベルマンの最適性の原理がその方法を示している:
最適性の原理(Principle of Optimality) : 最適な方策は、初期状態と初期決定がどんなものであれ、その結果得られる次の状態に関して、以降の決定が必ず最適方策になっているという性質をもつ。 (参照: Bellman, 1957、Chap. III.3.)
コンピュータ・サイエンスでは、このように分割できる問題の事を「部分構造最適性(optimal substructure)を持つ」と表現する。 この原理は、動的ゲーム理論における部分ゲーム完全均衡(subgame perfect equilibrium)と相似な概念である。ただし、動的ゲーム理論における最適方策は、相手プレイヤーが同様に最適方策を選択するという前提に立つ。
最適性の原理から示唆されるように、我々は将来の選択(時刻1から新しい状態 でスタートする)について一旦保留して、最初の決定だけを独立に検討する。将来の決定に関する項を大括弧の中に集めることにより、先の問題は次のように表現される。

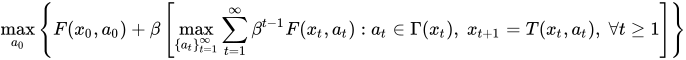
ただし次の条件のもとで:
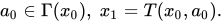
ここで時刻1での状態が となることを知りつつ、アクション を選ぶ。この新しい状態は、時刻1以降すべての決定に影響を与える。 未来全体の決定問題は、右側の角括弧の中に現れている。
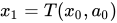

ベルマン方程式
これまでのところ、我々は単に現在の決定を未来の決定から分割することによって、単に問題を厄介にしたにすぎないように見える。だが、右側の角括弧の中を状態 から始まった時点1における意思決定問題の価値として表せたことで、問題の単純化が可能になっている。
従って、問題を価値関数に関する再帰的な定義式として書き直すことができる。
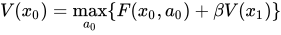
ただし次の条件のもとで:
これがベルマン方程式である。時間に関する添え字を省略し、次の状態を代入することにより、式をより単純化できる。
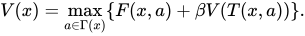
ベルマン方程式を解くことは、未知の関数 (価値関数)を見出すことである。ゆえにベルマン方程式は汎関数方程式に属している。価値関数は目的の実現可能な最良値を状態 の関数として表していることを思い出そう。価値関数を計算することによって、同時に我々は最適なアクションを状態の関数 として得ることができる。これを方策関数(policy function)と呼ぶ。


確率的な問題におけるベルマン方程式
決定論的な条件では、上述の最適制御問題を解くために動的計画法以外の手法を用いることが出来る。ある種の問題に対しては、この手法は便利であるが、確率過程のもつ性質に注意する必要がある。
経済学における具体的な例題として、時刻 において初期富(初期資産) を持ち、無限の寿命を持つ消費者を考える。彼は、瞬間的効用関数 を持つとする。ただし、 は消費額を表し、次の時刻における割引率を とする。時刻 において消費されなかった富は、金利 と共に次の時刻に繰り越される。すると消費者の効用最大化問題は、消費計画 を次式によって決定する問題となる。


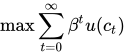
ただし次の条件のもとで:
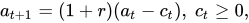
および

最初の条件は、問題設定に記述された資本の蓄積を示し、二つ目の条件は消費者が人生の終わりに置いて負債を先送りできないという横断性条件を示す。 ベルマン方程式は次式となる。
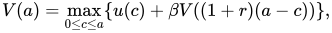
この代わりに、同じ問題を例えばハミルトン方程式で扱う事もできる。
今、金利が時間とともに変化するとすれば、消費者は確率的最適化問題に直面する。金利 がマルコフ過程に従い、その推移確率測度を 、ただし、 を現在の金利が の時に次の時刻の金利の変動を決定する確率測度であるとしよう。このモデルでは、現在の金利が示された直後に、消費者が決定を下すものとする。


この場合、単純な消費の系列 を選ぶ代わりに、消費者は彼/彼女の全人生にわたる効用の期待値が最大となるように を各時点でのあり得る利率 に応じて選ばなくてはならない。

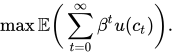
期待値 は、金利 の系列に関してで与えられる確率測度に関して計算される。 はマルコフ過程なので、問題は動的計画法によって劇的に単純化される。ベルマン方程式は単に以下の形となる。


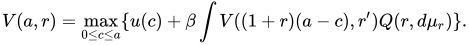
ある一般的な仮定のもとで、結果として得られる最適な方策関数 は可測となる。

マルコフ的なショックを伴い、主体が事後に選択を行うような一般的な確率的時系列の最適化問題に対しては、ベルマン方程式は非常に良く似た形をとる。
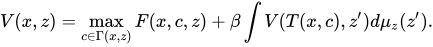
解法
- 未定係数法(「山勘と確認 (guess and verify)」としても知られる)は、ある種の無限期間(infinite horizon)の自律的なベルマン方程式を解くために用いられる。
- ベルマン方程式は後ろ向き推論(backward induction)によって解くことができる。特別な場合には解析的に解けるほか、コンピュータにより数値解を得ることができる。数値的な後ろ向き推論は、さまざまな問題を解くのに応用できるが、状態変数が多い場合には次元の呪いのために非現実的な方法となる。これに対して、近似動的計画法は、ベルマン関数を近似するためにニューラルネットワーク(多層パーセプトロン)を用いる方法で、 D・P・BertsekasとJ・N・Tsitsiklisによって提案された[5]。この方法は全状態空間の関数写像を記憶する問題を単一のニューラルネットワークのパラメータの記録によって置き換えることで、高次元における計算量爆発の問題を緩和する効果的な戦略である。
- ベルマン方程式に関連する一次の条件を計算し、価値関数の微分項を包絡線定理 (envelope theorem) によって消去することにより、システムの差分方程式、ないし、オイラー方程式と呼ばれる微分方程式を導くことができる。これらの差分方程式や微分方程式は標準的な手法を用いて解くことができ、状態変数の動的な変化や最適化問題の解となる制御変数を計算できる。
経済学への応用
経済学において最初にベルマン方程式を適用した例として知られるのが、Martin Beckmann と Richard Muth の研究である[6]。さらに、Martin Beckmann はベルマン方程式を利用した消費理論に関する論文を1959年に発表した。彼の仕事は、特にエドムンド・フェルプスに影響を受けたものである。
ベルマン方程式の経済学への応用として、特に有名なのがロバート・マートンが1973年に発表した 異時点間CAPMである[7] (マートンのポートフォリオ問題もまた参照)。マートンの理論モデルにおいて、投資家が現在の収入と将来の収入もしくはキャピタルゲインを比較して判断をおこなう場合の解はベルマン方程式となる。動的計画法を経済学に応用する場合、結果として得られるベルマン方程式は差分方程式となるため、経済学者は動的計画法を「再帰的方法」と呼ぶ。そのため現在では、再帰的経済学は、経済学の一分野として認識されている。
ナンシー・ストーキー、ロバート・ルーカス、エドワード・プレスコットは確率的/非確率的動的計画法について細部まで詳細に記述し、さまざまな条件における解の存在定理を得た。彼らは同時に再帰的手法を用いて経済学理論のさまざまな問題のモデル化について多くの例を示した[8]。 この著作は経済学における様々な問題を解くために動的計画法を利用する道を開いた。例えば、最適な経済成長は、資源開発、プリンシパル=エージェント理論、公共財政、事業投資、資産価格、供給要因、産業組織である。 ラース・リュングヴィストとトーマス・サージェントは金融政策、 財政政策、 課税、 経済成長、サーチ理論、 労働経済学などにおける様々な理論的問題を研究するために動的計画法を用いた[9]。アビナッシュ・ディキシットとロバート・ピンダイクは、資本予算について考察することでこの手法の価値を示した[10]。Andersonはこの手法を非公開企業を含んだ事業評価技術に適用した[11]。
具体的な問題を解くために動的計画法を利用するには、観測できない割引率(discount rate)の決定のような、情報上の困難によって複雑なものになる。 さらに取りうる膨大な数のアクションと状態変数によって生ずる次元の呪いに起因する計算技術上の問題が、最適戦略を得る前に立ちはだかる。このような計算上の問題については、Miranda と Fackler[12]、あるいは Meyn 2007 を見よ[13]。
例
マルコフ決定過程(MDP) において、ベルマン方程式は期待報酬(expected reward)に関する再帰的な関係を表現する。例えば、特定の状態 において方策 を適用した際の期待報酬は以下のベルマン方程式を満たす:


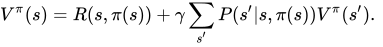
この方程式は、ある方策 のもとで得られる期待報酬を表している。
最適な方策を採用した場合の方程式が最適ベルマン方程式である:
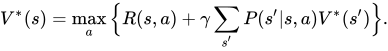
この式は、最適な行動をとった場合に得られる期待報酬を表す。
参考文献
- Bellman, R.E. 1957. Dynamic Programming. Princeton University Press, Princeton, NJ. Republished 2003: Dover, ISBN 0-486-42809-5.
- S. Dreyfus (2002), 'Richard Bellman on the birth of dynamic programming' Archived 2005年1月10日, at the Wayback Machine. Operations Research 50 (1), pp. 48–51.
- 時間選好率のこと。
- R Bellman, On the Theory of Dynamic Programming, Proceedings of the National Academy of Sciences, 1952
- Bertsekas, D. P., Tsitsiklis, J. N., Neuro-dynamic programming. Athena Scientific, 1996
- Beckmann, Martin; Muth, Richard (1954). “On the Solution to the ‘Fundamental Equation’ of inventory theory”. Cowles Commission Discussion Paper 2116.
- Merton, Robert C. (1973). “An Intertemporal Capital Asset Pricing Model”. Econometrica 41 (5): 867–887. JSTOR 1913811.
- Stokey, Nancy; Lucas, Robert E.; Prescott, Edward (1989). Recursive Methods in Economic Dynamics. Harvard Univ. Press.. ISBN 0-674-75096-9
- Ljungqvist, Lars; Sargent, Thomas (2012). Recursive Macroeconomic Theory (Third ed.). MIT Press. ISBN 978-0-262-01874-6
- Dixit, Avinash; Pindyck, Robert (1994). Investment Under Uncertainty. Princeton Univ. Press. ISBN 0-691-03410-9
- Anderson, Patrick L., Business Economics & Finance, CRC Press, 2004 (chapter 10), ISBN 1-58488-348-0; The Value of Private Businesses in the United States, Business Economics (2009) 44, 87–108. doi:10.1057/be.2009.4. Economics of Business Valuation, Stanford University Press (2013); ISBN 9780804758307. Stanford Press
- Miranda, M., & Fackler, P., 2002. Applied Computational Economics and Finance. MIT Press
- S. P. Meyn, 2007. Control Techniques for Complex Networks Archived 2008年5月13日, at the Wayback Machine., Cambridge University Press, 2007. Appendix contains abridged Meyn & Tweedie Archived 2007年10月12日, at the Wayback Machine..
関連項目
- 再帰的競争均衡(英語: recursive competitive equilibrium)
- 最適制御理論
- 動的計画法
- ハミルトン-ヤコビ-ベルマン方程式
- 微分動的計画法
- 部分構造最適性(英語: Optimal substructure)
- ベルマンの擬スペクトル的方法(英語: Bellman pseudospectral method)
- マルコフ決定過程