ルービン因果モデル
ルービン因果モデル(ルービンいんがモデル、Rubin causal model、RCM)は、ネイマン-ルービン因果モデルとしても知られ [1]、ドナルド・ルービンにちなんで名付けられた、潜在アウトカムのフレームワークに基づく原因と結果の統計分析へのアプローチである。 「ルービンの因果モデル」という名前は、 Paul W.Hollandによって最初に造られた [2]。潜在的な結果のフレームワークは、1923年の修士論文でイェジ・ネイマンによって最初に提案されたが [3]、完全にランダム化された実験の文脈でしか議論されなかった [4]。ルービンはそれを観察研究と実験研究の両方で因果関係について考えるための一般的な枠組みに拡張した 。
前書き
ルービン因果モデルは、潜在的な結果のアイデアに基づいている。たとえば、大学に通っていた場合は40歳で特定の収入があるが、大学に通っていなかった場合は40歳で別の収入がある。この人の大学への進学の因果関係を測定するには、両方の選択肢の将来における同じ個人の結果を比較する必要がある。両方の潜在的な結果を一度に確認することは不可能であり、潜在的な結果の1つが常に欠落している。このジレンマは「因果推論の根本的な問題」である。
因果推論の根本的な問題のため、ユニットレベルの因果効果を直接観察することはできない。ただし、ランダム化された実験では、母集団レベルの因果効果の推定が可能である [5]。ランダム化実験では、人々を無作為に処置(この例では大学進学の有無)に割り付ける。無作為割り付けのために、グループは(平均して)同等であり、40歳での収入の違い以外にはグループ間の唯一の違いがない。このため、40歳での収入が大学進学の有無の割り付けに起因する可能性がある。次に、平均因果効果(平均処置効果とも呼ばれる)の推定値は、処置群の標本(大学に通った人たち)とコントロール群の標本(大学に通わなかった人たち)の間の平均の差を計算することによって取得できる。
ただし、多くの場合、倫理的または実践的な懸念から、ランダム化実験は不可能である。このようなシナリオでは、ランダムではない割り付け方法が存在する。大学進学の例の場合、人々は大学進学を無作為には割り当てられていない。むしろ、人々は自分の経済状況や両親の教育などに基づいて大学に進学するかを選ぶだろう。傾向スコア・マッチングなど、因果推論のために多くの統計手法が開発されている。これらの方法は、処置群の標本とよく似たコントロール群の標本を見つけ、割り付け方法に対して修正しようとする。
拡張例
ルービンは以下のように因果効果を定義している[5]。
直感的には、特定の被験者の時刻 から における処置 C に対する処置 E の因果効果とは、「時刻 から処置 E を行った場合に時刻 において何が起こるか」と「時刻 から処置 C を行った場合に時刻 において何が起こるか」との差である。
「1時間前に、グラス一杯の水を飲むだけではなく、アスピリンを 2 錠内服していれば、今ごろ頭痛はなくなっていただろう」とか、「1時間前に、グラス一杯の水を飲むだけではなく、アスピリンを 2 錠内服したので、もう頭痛はなくなった」とか。
我々が定義した処置 E に対する処置 C の因果効果は、この直感的な意味を反映している。


RCM によると、1時間前にアスピリンを服用したかどうかの因果関係は、ケース1(アスピリンを服用)とケース2(アスピリンを服用しない)で頭がどのように感じたかの違いである。頭痛がアスピリンなしで残るが、アスピリンを服用した場合に消えるならば、アスピリンを服用することの因果効果は頭痛の軽減である。ほとんどの場合、1つは一般に「治療」と呼ばれ、もう1つは「コントロール」と呼ばれる2つの未来を比較することに関心がある。これらのラベルはやや恣意的である。
潜在アウトカム
ジョーが新しい高血圧薬のFDAテストに参加していると仮定する。私たちが全知ならば、治療(新薬)とコントロール(治療なし または標準治療)の両方の下でのジョーのアウトカム(結果)が分かる。因果効果、すなわち治療効果は、これら2つの潜在アウトカム Potential outcomesの違いである。
| 件名 | |||
|---|---|---|---|
| ジョー | 130 | 135 | −5 |


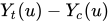
はジョーが新薬を服用した場合の血圧を示す。 一般に、この表記法は、被験者 u における治療 t から生じる潜在アウトカムを表す。 同様に、は、被験者 u に対するコントロールの効果を示す。 この例だと、 は新薬を服用しない場合のジョーの血圧を示す。 が新薬を服用した場合の因果効果を示す。
この表からは、ジョーにおける因果効果だけがわかる。 他の被験者は、全員、新薬を服用すると血圧が上昇するかもしれない。 他の被験者の因果効果に関係なく、ジョーの因果効果は、新薬を服用していなかった場合の血圧に比べて血圧が低いこと、となる。
被験者を増やしてみる。
| 被験者 | |||
|---|---|---|---|
| ジョー | 130 | 135 | −5 |
| メアリー | 140 | 150 | −10 |
| サリー | 135 | 125 | 10 |
| ボブ | 135 | 150 | −15 |
因果効果は、すべての被験者で異なっているが、因果効果がマイナスであることから、新薬はジョー、メリー、ボブに「有効」であるといえる。彼らの血圧は、それぞれが新薬を服用しなかった場合よりも新薬を使用した方が低くなる。一方、サリーの場合、新薬は血圧の上昇を引き起こす。
潜在アウトカムが意味を成すためには、少なくとも事前(a priori)にそれが可能でなければならない。 たとえば、ジョーがどうやっても新薬を入手できない場合は、 は彼には不可能である。 それは決して起こり得ない。そしてもし が理論的にも観察することができないのならば、ジョーの血圧に対する新薬の因果効果は定義されない。
操作なくして因果なし
新薬の因果効果は、2つの潜在アウトカムの単純な差であり、どちらも発生する可能性があるため、明確に定義されている。この場合、私たち(または他の何か)は、少なくとも概念的には世界を操作できるため、あることが起こったり、別のことが起こったりする可能性がある。
潜在アウトカムの 1 つが発生しない場合、この因果効果の定義は問題になる。たとえば、ジョーの身長が体重に及ぼす因果関係は何だろうか?素朴に考えると、これは他の例と似ているように思える。 2つの潜在アウトカムを比較する必要がある。処置群(3 インチ高い身長として定義)の場合のジョーの体重と、コントロール群(現行の身長として定義)の場合のジョーの体重だ。
少し考えれば問題が浮き彫りになる:ジョーの身長を上げることはできない。ジョーを背の高くする方法がないため、概念的にも、ジョーが背が高い場合の体重を観察する方法はない。ジョーの身長を「操作」することはできないので、身長が体重に及ぼす因果関係を調査することは意味がない。そこでスローガン:
NO CAUSATION WITHOUT MANIPULATION(操作なくして因果なし)
—Holland,Statistics and Causal Inference[6]
SUTVA
ある被験者における [潜在アウトカムの] 観測は、他の被験者への治療の割り付けによって影響を受けないようにする必要がある
—D. R. Cox,Planning of Experiments[7]
ドナルド・ルービンは、以下の 2 つを満たすものを Stable Unit Treatment Value Assumption(SUTVA)として定義した[8]。 なお、サトヴァと発音する[9]。
- 解析の単位(個人、集団など)間で相互干渉がない - there is no interference between units
- 同じ処置なら内容は同じ(内容が違うなら別の処置として扱う)- there are no hidden versions of treatmen how unit i received treatment
これまでの例で考えると、ジョーの血圧はメアリーが新薬を受け取るかどうかに依存するべきではない。しかし、もしそうならどうなるだろうか?ジョーとメアリーが同じ家に住んでいて、メアリーがいつも料理をしているとする。新薬を服用するとメアリーは塩辛い食べ物が食べたくなり、新薬を服用しない場合よりも多くの塩を使って調理する。 高食塩食はジョーの血圧を上昇させる。 したがって、ジョーのアウトカムは、ジョーが服薬とメアリーの服薬の両方に依存する。
SUTVA違反は、因果推論をより困難にする。より多くの治療を検討することにより、それに依存する観測値を説明できる。 ジョーの服薬の有無だけでなく、メアリーの服薬の有無も加味して、以下の4パターンを考える。
| ジョーの服薬 | メアリーの服薬 | ジョーの血圧 |
|---|---|---|
| なし | あり | 140 |
| あり | あり | 130 |
| なし | なし | 125 |
| あり | なし | 120 |
因果効果は、2つの潜在アウトカムの違いとして定義される。 この例では潜在アウトカムが2つより多く、複数の因果関係が考えられる。 第一に、メアリーが服薬した場合における、ジョーの服薬とジョーの血圧との因果関係であり、 として計算される。 第二に、メアリーが服薬しなかった場合における、ジョーの服薬とジョーの血圧との因果関係であり、 として計算される。 第三に、ジョーが服薬しなかった場合における、メアリーの服薬とジョーの血圧との因果関係であり、 として計算される。 ジョーの血圧に対する因果効果は、メアリーの服薬によるものの方がジョー服薬によるものよりも大きく、その方向は反対である。


このように、より多くの潜在アウトカムを検討することにより、SUTVAを保持させることができる。 ただし、ジョー以外の被験者がメアリーの服薬に依存している場合は、さらなる潜在アウトカムを考慮する必要がある。 従属ユニットの数が多いほど、考慮しなければならない潜在アウトカムが多くなり、計算が複雑になる(20 人の治療のそれぞれが 20 人全員のアウトカムに影響を与える事態を想像しよう)。 コントロールと比較した単一の処置の因果効果を(簡単に)推定するためには、SUTVAの成立が必要である。
平均的な因果効果
以下の例を考える
| 被験者 | |||
|---|---|---|---|
| ジョー | 130 | 135 | −5 |
| メアリー | 130 | 145 | −15 |
| サリー | 130 | 145 | −15 |
| ボブ | 140 | 150 | −10 |
| ジェームズ | 145 | 140 | +5 |
| 平均 | 135 | 143 | −8 |
すべての因果効果の平均を取ることにより、平均因果効果を「計算」することができる。
反応をどのように測定するかは、推論結果に影響する。血圧の変化を絶対値ではなく変化率として測定したとき、具体的な値によっては、平均的な因果効果としては血圧の上昇になる可能性がある。
たとえば、ジョージの血圧がコントロールで154、治療で140になると仮定する。因果効果の絶対値は -14 だが、治療した場合の140に対してパーセンテージの差を計算すると -10% である。サラの血圧が治療で200、コントロールで184である場合、因果効果は絶対値では +16 だが、治療値では +8% である。ジョージの血圧の変化は絶対値では小さい(-14対+16)が、変化率では大きくなる(-10%対+8%)。ジョージとサラの平均因果効果は絶対値では +1 だが、パーセンテージで考えると -1 となる。
因果推論の根本問題
これまでに見たアウトカムは、実際には測定されない。定義上、特定の期間にわたって被験者に対する複数の治療の効果を観察することは不可能である。ジョーは「新薬を服用すること」と「新薬を服用しないこと」の両者を同時に満たすことはできない。したがって、データは次のようになる。
| 被験者 | |||
|---|---|---|---|
| ジョー | 130 | ? | ? |
疑問符は、観察できなかった反応を示す。因果推論の根本問題 Fundamental Problem of Causal Inference [2] とは、因果効果を直接観察することは不可能であるということである。ただし、これによって「因果推論」そのものが不可能になるわけではない。特定の技術と仮定により、根本問題を克服することができる。
次のデータがあると仮定する。
| 被験者 | |||
|---|---|---|---|
| ジョー | 130 | ? | ? |
| メアリー | ? | 125 | ? |
| サリー | 100 | ? | ? |
| ボブ | ? | 130 | ? |
| ジェームズ | ? | 120 | ? |
| 平均 | 115 | 125 | −10 |
効果が一定であるものとを仮定した場合、コントロールにおけるジョーの潜在アウトカムを推測できる。
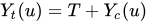
そして
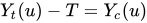
観測されていない値を推測したい場合、効果が一定であることを仮定することができる。次の表は、効果が一定であることを仮定した場合に合致するデータを示している。
| 被験者 | |||
|---|---|---|---|
| ジョー | 130 | 140 | −10 |
| メアリー | 115 | 125 | −10 |
| サリー | 100 | 110 | −10 |
| ボブ | 120 | 130 | −10 |
| ジェームズ | 110 | 120 | −10 |
| 平均 | 115 | 125 | −10 |
治療した場合のアウトカムは異なるが、すべての被験者の因果効果は同じである。
割り付け方法
割り付け方法(被験者に処置をどのように割り付けるか)は、平均因果効果の計算に影響を与える。無作為割り付けは割り付け方法の 1 つである。各被験者について、コインを投げて、彼女が治療を受けているかどうかを判断することができる。 5人の被験者に治療を受けさせたい場合は、帽子から選んだ最初の5つの名前に治療を割り当てることができる。無作為に治療を割り付けると、異なる答えが得られる場合がある。
このデータが真実であると仮定する。
| 被験者 | |||
|---|---|---|---|
| ジョー | 130 | 115 | 15 |
| メアリー | 120 | 125 | −5 |
| サリー | 100 | 125 | −25 |
| ボブ | 110 | 130 | −20 |
| ジェームズ | 115 | 120 | −5 |
| 平均 | 115 | 123 | −8 |
真の平均因果効果は -8 である。しかし、これらの個人の因果関係は、この平均に等しくなることはない。因果効果は、一般的に(常に?)実際の生活と同じようにさまざまである。処置を無作為に割り付けた後、因果効果を次のように推定することができる。
| 被験者 | |||
|---|---|---|---|
| ジョー | 130 | ? | ? |
| メアリー | 120 | ? | ? |
| サリー | ? | 125 | ? |
| ボブ | ? | 130 | ? |
| ジェームズ | 115 | ? | ? |
| 平均 | 121.66 | 127.5 | −5.83 |
処置の割り付け方が異なると、平均因果効果の推定値も異なる。
| 被験者 | |||
|---|---|---|---|
| ジョー | 130 | ? | ? |
| メアリー | 120 | ? | ? |
| サリー | 100 | ? | ? |
| ボブ | ? | 130 | ? |
| ジェームズ | ? | 120 | ? |
| 平均 | 116.67 | 125 | −8.33 |
標本数が小さく、応答の分散が大きいため、平均的な因果効果は異なる。標本数が大きく、分散が小さければ、誰が処置に無作為に割り付けられるかに関係なく、平均因果効果は真の平均因果効果に近くなる。
男性を治療に、女性をコントロールに割り付ける場合を考える。
| 件名 | |||
|---|---|---|---|
| ジョー | 130 | ? | ? |
| ボブ | 110 | ? | ? |
| ジェームズ | 105 | ? | ? |
| メアリー | ? | 130 | ? |
| サリー | ? | 125 | ? |
| スージー | ? | 135 | ? |
| 平均 | 115 | 130 | −15 |
この割り付け方法では、女性が治療を受けることは不可能であるため、女性の被験者に対する平均的な因果関係を判断することは不可能となる。被験者への因果関係を推測するには、被験者が治療を受ける確率が 0 より大きく 1 より小さい必要がある。
完璧な医師
割り付け方法として「完璧な医師」を採用する。完璧な医師は、各被験者が処置またはコントロールにどのように反応するかを知っており、各被験者を最も利益をもたらす方に割り付ける。完璧な医師は、患者に関する以下の情報を知っている。
| 件名 | |||
|---|---|---|---|
| ジョー | 130 | 115 | 15 |
| ボブ | 120 | 125 | −5 |
| ジェームズ | 100 | 150 | −50 |
| メアリー | 115 | 125 | −10 |
| サリー | 120 | 130 | −10 |
| スージー | 135 | 105 | 30 |
| 平均 | 120 | 125 | −5 |
この知識に基づいて、完璧な医師は次のように割り当てる。
| 件名 | |||
|---|---|---|---|
| ジョー | ? | 115 | ? |
| ボブ | 120 | ? | ? |
| ジェームズ | 100 | ? | ? |
| メアリー | 115 | ? | ? |
| サリー | 120 | ? | ? |
| スージー | ? | 105 | ? |
| 平均 | 113.75 | 110 | 3.75 |
完璧な医師は、処置とコントロールの両方に対する悪い反応を排除することにより、それぞれの平均を歪める。平均因果効果の推定量である平均の差も歪み、歪む方向は細部に依存する。たとえば、スージーのように薬を服用することで害を受けた被験者は、完璧な医師によってコントロール群に割り当てられるため、薬の悪影響は隠される。
結論
ある時点での単一の被験者に対する治療の因果効果は、治療ありと治療なしのアウトカムの差である。因果推論の根本的な問題は、単一の被験者に対する因果効果を観察することが不可能であるということだ。あなたはアスピリンを服用するか、服用しないかのどちらかだ。結果的に、欠落している反事実を推定するために仮定を置く必要がある。
ルービン因果モデルは操作変数法や構造方程式モデリングなどの因果推論手法にも関連がある[10] [11]。
関連項目
- 因果関係
- 主な層別化
- 傾向スコア・マッチング
参考文献
- Imbens, Guido; Rubin, Donald (2015). Causal Inference for Statistics, Social, and Biomedical Sciences: An Introduction. Cambridge: Cambridge University Press. doi:10.1017/CBO9781139025751. ISBN 9781139025751
- Rubin, Donald (1977). “Assignment to Treatment Group on the Basis of a Covariate”. Journal of Educational Statistics 2: 1-26.
- Rubin, Donald (1978). “Bayesian Inference for Causal Effects: The Role of Randomization”. The Annals of Statistics 6: 34-58.
脚注
- Sekhon, Jasjeet (2007). “The Neyman–Rubin Model of Causal Inference and Estimation via Matching Methods”. The Oxford Handbook of Political Methodology
- Holland, Paul W. (1986). “Statistics and Causal Inference”. Journal of the American Statistical Association 81 (396): 945–960. doi:10.1080/01621459.1986.10478354. JSTOR 2289064.
- Neyman, Jerzy. Sur les applications de la theorie des probabilites aux experiences agricoles: Essai des principes. Master's Thesis (1923). Excerpts reprinted in English, Statistical Science, Vol. 5, pp. 463–472. (D. M. Dabrowska, and T. P. Speed, Translators.)
- Rubin, Donald (2005). “Causal Inference Using Potential Outcomes”. Journal of the American Statistical Association 100 (469): 322–331. doi:10.1198/016214504000001880.
- Rubin, Donald (1974). “Estimating Causal Effects of Treatments in Randomized and Nonrandomized Studies”. Journal of Educational Psychology 66 (5): 688–701. doi:10.1037/h0037350.
- Paul W. Holland. “Statistics and Causal Inference”. Journal of the American Statistical Association (Taylor & Francis, Ltd. on behalf of the American Statistical Association) 81 (396): 945-960.
- D. R. Cox (1958). Planning of Experiments
- Donald B. Rubin (2005). “Causal Inference Using Potential Outcomes: Design, Modeling, Decision”. Journal of the American Statistical Association 100 (469): 322-331.
- 高橋将宜、2022、『統計的因果推論の理論と実装』、共立出版
- Angrist, J.; Imbens, G.; Rubin, D. (1996). “Identification of Causal effects Using Instrumental Variables”. Journal of the American Statistical Association 91 (434): 444–455. doi:10.1080/01621459.1996.10476902.
- Morgan, S.; Winship, C. (2007). Counterfactuals and Causal Inference: Methods and Principles for Social Research. New York: Cambridge University Press. ISBN 978-0-521-67193-4
外部リンク
- 「ルービン因果モデル」 :ギード・インベンズとドナルド・ルービンによる New Palgrave Dictionary of Economics の記事
- Counterfactual Causal analysis(反事実的因果分析) :スティーブン・モーガン、クリストファー・ウィンシップ、その他によって維持されているウェブページで、因果推論に関する多くの研究記事へのリンクがある