局所性鋭敏型ハッシュ
局所性鋭敏型ハッシュ(きょくしょせいえいびんがたハッシュ、英語: locality sensitive hashing)とは高次元のデータを確率的な処理によって次元圧縮するための手法である。ハッシュの基本的な考え方は類似したデータが高確率で同じバケットに入るようにデータを整理するというものである。多くの場合においてこのバケットの数は入力されるデータサンプルの数よりもずっと小さくなる。
定義
局所性鋭敏型ハッシュを行うためのパラメータの集合をLSH族(Locality Sensitive Hashing Family)と呼ぶ。LSH族は距離空間と閾値、近似因子によって定義される。LSH族[1][2]は2点について次の2つの性質、


- ならばとなる確率は以上である。
- ならばとなる確率は以下である。


を満たす関数により与えられる族であり,はから一様乱数にしたがって選択される。このときは2点の距離を表す関数であり、となるよう設計する。このような族はに鋭敏であるという。


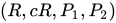
これに準ずる定義として、領域における類似度関数によるものがある[3]。局所性鋭敏型ハッシュの性質は、ハッシュ関数の集合と確率分布により与えられる。あるハッシュ関数は集合から確率分布により選ばれるが、とは領域に存在する2点について、

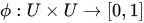


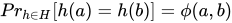
を満たすような確率分布である。
手法
ハミング距離に基づく標本化
LSH族を構築するためのもっとも単純な手法はハミング距離に基づくものである。これは次元のベクトルに対して適応できる。この手法は次元のベクトルについて番目の座標値をハッシュ値として与えるような族により定義され、とは例えばのように与えられる。ここでからを任意に選ぶということは、入力点から任意にビットを選択するということに他ならない。この時、族は次の性質を持つ。


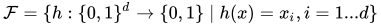
- ,
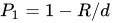
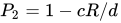


出典
- Gionis, A.; Indyk, P., Motwani, R. (1999). , “Similarity Search in High Dimensions via Hashing”. Proceedings of the 25th Very Large Database (VLDB) Conference.
- Indyk, Piotr.; Motwani, Rajeev. (1998). , “Approximate Nearest Neighbors: Towards Removing the Curse of Dimensionality.”. Proceedings of 30th Symposium on Theory of Computing.
- Charikar, Moses S.. (2002). “Similarity Estimation Techniques from Rounding Algorithms”. Proceedings of the 34th Annual ACM Symposium on Theory of Computing 2002: (ACM 1–58113–495–9/02/0005)…. doi:10.1145/509907.509965 2007年12月21日閲覧。.
- Datar, M.; Immorlica, N., Indyk, P., Mirrokni, V.S. (2004). “Locality-Sensitive Hashing Scheme Based on p-Stable Distributions”. Proceedings of the Symposium on Computational Geometry.
- Pauleve, L.; Jegou, H., Amsaleg, L. (2010). “Locality sensitive hashing: A comparison of hash function types and querying mechanisms”. Pattern recognition Letters.
This article is issued from Wikipedia. The text is licensed under Creative Commons - Attribution - Sharealike. Additional terms may apply for the media files.