DAISYプロジェクト
DAISYプロジェクト(デイジィプロジェクト)とは、2000年3月ヤマハが開始したVOCALOID開発プロジェクト[1]のコードネームである[2]。この名称は、1961年、ベル研究所の公開実験でコンピュータが世界で初めて歌った歌"Daisy Bell"[3]をリスペクトして命名された。なお正式名称は「VOCALOID」に決まり、2003年2月に正式発表された[4]。
経緯
2000年4月[5]バルセロナのポンペウ・ファブラ大学 Music Technology Group(MTG)との共同研究が開始され、VOCALOIDの信号処理部分が開発された[6][2]。2002年5月札幌のクリプトン・フューチャー・メディア、同年秋イングランドのZero-G Limited、他1社との接触が開始され、後に(少なくとも前述2社と)歌声ライブラリ制作とソフトウェア販売に関するライセンス供与の合意に達した。その後2003年2月26日の開発に関するプレス発表[4]、同年3月MusikmesseとAESコンベンションにおけるプロトタイプ展示・発表を経て、2004年1月、NAMM Showで最初のVOCALOID製品LeonとLolaがZero-Gから発表され、日本国内では同年3月3日に発売された。
ヤマハとMTGの共同研究
Music Technology Group
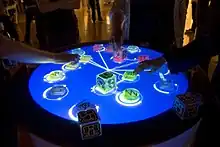
ヤマハが共同研究を行ったポンペウ・ファブラ大学 Music Technology Group(MTG)は、1994年に設立された音と音楽のコンピューティングに関する研究グループで、現在約40名の研究者が所属し、信号処理・音響・音楽・演奏モデル・音楽コミュニケーション等の研究を行っている。2005年発表の実世界インタフェースを使った仮想モジュラーシンセサイザー Reactableも、このMTGの研究開発成果の一つである。その他 Freesoundプロジェクト(Freesound.org)、音楽関連IT企業 BMATなどの活動が知られている。
Xavier Serra

MTG創立者でディレクターのXavier Serraは、1980年代にはスタンフォード大学CCRMAに所属し、物理モデリング・シンセシスで著名なJulius O. Smithと共に、MQ手法と同様なフェーズボコーダのピッチトラッキング拡張による分析/合成手法PARSHLを1987年開発した。また1989年には、McAuleyとQuatieriがMQ手法で提案した正弦波ベースの音声分析/合成手法 Sinusoidal modeling[7]の拡張として、音響モデルに音声合成で実績のあるノイズ成分を加えたインハーモニックな楽音分析/合成手法 Spectral modeling synthesis(SMS)を提案した。このSMS手法は、2000年4月開始のVOCALOIDの共同研究でも基盤技術の一つとして活用されている。
共同研究の成果
Loscos (2007)によれば、MTGとヤマハの共同研究で開発された信号処理手法は、2001〜2003年の三つの論文 Bonada & Loscos (2003)、Bonada et al. (2003)、Bonada et al. (2001)で発表された。この研究ではフレームベースの周波数領域テクニック(diphone等のフレーム単位に区切られた音声素片を周波数領域で処理する手法)を使って、与えられた楽譜と歌詞に従って歌声データベース上の音声素片を移調/時間伸縮/連結して歌声を合成するシステムが示された[8]。
この研究の音声モデルは、スペクトル・モデルの1つ SMS手法による「調波+残余」表現をベースに、準物理モデルの1つソース・フィルタモデルの拡張として新規開発された Excitation plus Resonances(EpR)音声モデルによる「励起+共鳴」表現を組合せて表現される。なおモデルと元波形の相違は、分析時に差分スペクトル形状として保存し、再合成時に加算して音質変化を抑制する[9][10]。
歌声合成の基盤として、phase-locked vocoder[11][12]に基づく[13][脚注 1]フレームベースのスペクトル分析/合成手法Spectral peak processing(SPP)を使ったサンプル変形手法 —— 時間スケーリング、スペクトルの非線形スケーリングによるピッチ変換、位相補正、スペクトル包絡のピーク強度調整[6](equalization)による音色調整 —— が開発された[8][14]。また素片接続に関しては、素片フレーム間に遷移フレームを挿入し、上記サンプル変形手法を使って位相接続やスペクトル形状接続(いわゆるスペクトル包絡補間[6])を行う手法が開発された[15]。
なお製品版VOCALOIDで実際に採用された技術については、たとえば剣持 & 大下 (2008)に概略説明がある。
参考文献
- Bonada, J.; Celma, O.; Loscos, A.; Ortola, J.; X. Serra, Y. Yoshioka, H. Kayama, Y. Hisaminato, H. Kenmochi (2001), “Singing voice synthesis combining Excitation plus Resonance and Sinusoidal plus Residual Models”, Proc. of ICMC, CiteSeerx: 10.1.1.18.6258(PDF)
- Bonada, Jordi; Loscos, Alex (2003), “Sample-based singing voice synthesizer by spectral concatenation”, Proc. of SMAC 03: 439–442
- Bonada, J.; Loscos, A.; Mayor, O.; Kenmochi, H. (2003), “Sample-based singing voice synthesizer using spectral models and source-filter decomposition”, Third International Workshop on Models and Analysis of Vocal Emissions for Biomedical Applications.
- Loscos, A. (2007), Spectral processing of the singing voice, Ph.D. Thesis, Pompeu Fabra University(PDF)
- 剣持, 秀紀 (2008), “歌唱合成システム VOCALOID と初音ミク”, デジタルコンテンツの知的財産権に関する調査研究報告書:進化するコンテンツビジネスモデルとその収益性・合法性 — VOCALOID2、初音ミク、ユーザ、UGMサイト、権利者 —, デジタルコンテンツ協会 (2008年3月発行), pp. 33–42
- 剣持 2008
- Loscos 2007, p. 3, "Daisy"
- 14. "Daisy Bell(Bicycle Built for Two)," Max Mathews(1961), “National Recording Registry Adds 25”, The Library Today (Library of Congress), (June 23, 2010)
- パソコン上でリアルな歌声を合成 歌声合成ソフトウェア『ヴォーカロイドVOCALOID』を開発, ヤマハ株式会社, (2003年2月26日), オリジナルの2007-01-01時点におけるアーカイブ。
- 小松陽一「事業創造と意味ネットワークの構造変化:「初音ミク」と米黒酢の事例をめぐる一考察」『日本情報経営学会誌』第30巻第1号、日本情報経営学会、2009年8月、88-98頁、ISSN 1882-2614。
- 剣持, 秀紀; 大下, 隼人 (2008), “歌声合成システムVOCALOID--現状と課題 (音楽情報科学 音声言語情報処理)”, 情報処理学会研究報告. [音楽情報科学] 2008 (12): 51-56
- McAulay, R.J.; Quatieri, T.F. (1986), “Speech Analysis/Synthesis Based on a Sinusoidal Representation”, Acoustics, Speech and Signal Processing, IEEE Transactions on ASSP-34 (4): 744–754 (PDF)
- Bonada & Loscos 2003
- Bonada 2001
- Loscos 2007, p. 51, "Excitation plus resonances voice model"
- Puckette, Mirror (1995), “Phase-locked vocoder”, Applications of Signal Processing to Audio and Acoustics, 1995., IEEE ASSP Workshop on: 222–225, doi:10.1109/ASPAA.1995.482995 (PDF)
- Laroche, Jean; Dolson, Mark (1999), “Improved Phase Vocoder Time-Scale Modification of Audio”, Speech and Audio Processing, IEEE Transactions on 7 (3): 323–332, doi:10.1109/89.759041
- Loscos 2007, p. 44, "Phase locked vocoder"
- Loscos 2007, p. 44, "Spectral peak processing"
- Bonada & Loscos 2003, p. 441, "6. Concatenating Samples"
脚注
- Spectral peak processing(SPP)は、phase-locked vocoderベースのSinusoidal modeling手法であり、分析結果としてSTFT表現の他に、調波ピークとピッチを出力する。Phase-locked vocoderとの主な相違点は
- スペクトル・ピーク周波数をパラボラフィッティングで推定しピッチ分析(ピッチトラッキング)し
- 調波成分と判定されたスペクトル・ピーク領域だけを分割処理する
関連項目
- VOCALOID
- ボーカルシンセサイザー
- 波形接続合成
- Spectral modeling synthesis(SMS)
- フェーズボコーダ
外部リンク
- Music Technology Group, Universitat Pompeu Fabra