トランスレーション・ルックアサイド・バッファ
トランスレーション・ルックアサイド・バッファ(英: Translation Lookaside Buffer、TLB)とは、メモリ管理ユニット内のある種のキャッシュであり、仮想アドレスから物理アドレスへの変換の高速化を図るものである。こんにちの仮想記憶をサポートするマイクロプロセッサは、仮想空間と物理空間のマッピングにTLBを利用しているのがほとんどである。
TLBは通常、連想メモリ (CAM) で実装されている。CPUがメモリ空間にアクセスする際、検索キーとして仮想アドレスを使い、TLB上にそのアドレスに対応するエントリがあれば、検索結果として対応する物理アドレスが返る。これを「TLBヒット」と呼ぶ。要求したアドレスがTLB内にない場合は「TLBミス」であり、アドレス変換のためにページテーブルを辿っていかなければならない。これを「ページウォーク」と呼ぶ。ページウォークは複数個所のメモリの内容を読み取り、そこから物理アドレスを計算しなければならず、時間がかかる作業である。ページウォークによって物理アドレスが判明した後、その仮想アドレスと物理アドレスのマッピングがTLBに格納される。
概要
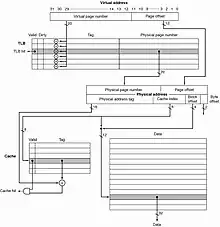
TLB には固定個のスロットがあり、仮想アドレスから物理アドレスへの変換のためのページテーブルエントリが入れられる。仮想アドレス空間はプロセスから見えるメモリ空間である。この空間は固定サイズのページに分割されている。ページテーブル(通常、メモリ上にある)は、仮想ページが物理メモリ上のどの位置に対応しているかを把握している。TLBはそのページテーブルのキャッシュとして機能する。すなわち、ページテーブルの中身のサブセットだけを格納する。
TLB には物理メモリアドレスが格納される。TLBはCPUとキャッシュメモリの間に置かれている場合もあるし、キャッシュと主記憶装置の間に置かれることもあるし、複数次のキャッシュ間に置かれる場合もある。これは、キャッシュが仮想アドレスを使っているか、物理アドレスを使っているかで決定される。キャッシュが仮想アドレスを使っている場合、メモリアクセス要求はCPUからキャッシュに直接伝えられ、キャッシュにヒットしなかった場合にTLBが使われる。キャッシュが物理アドレスを使っている場合、TLBはメモリアクセスの度に必ずアクセスされ、得られた物理アドレスを使ってキャッシュにアクセスする。どちらの実装にも利点と欠点がある。仮想アドレスを使うキャッシュの場合、仮想アドレスのキーとなる部分に加え、「アドレス空間識別子」(ASID) と呼ばれるキーも持つことがある。ASIDを持たない仮想キャッシュの場合、マルチプロセッシング環境ではコンテキストスイッチの度にキャッシュの内容をフラッシュしなければならない。
ハーバード・アーキテクチャまたはその系統の場合、命令とデータで仮想空間が分離していたり、メモリアクセス用ハードウェアが分離していたりする。その場合、命令とデータで別々のTLBを必要とする場合がある。
物理アドレス式のキャッシュでの最適化として、TLB参照とキャッシュアクセスを並行して同時に行う方式がある。仮想アドレスの下位ビット群(例えば、4KBページの仮想記憶方式なら、仮想アドレスの下位12ビット)はページ内オフセットであり、仮想-物理変換では変化しない。このため、キャッシュのインデックスがその変化しない範囲内であれば、アクセスすべきキャッシュラインは一意に定まり、TLBによる変換を待たずにキャッシュにアクセスできる。その後、そのキャッシュラインのタグ情報とTLBから得た物理アドレスを比較して、所望の物理アドレスの内容かどうかを判断する。キャッシュがページサイズより大きい場合でもTLBアクセスとキャッシュアクセスを並行して行うことも可能である。その場合、キャッシュのインデックスには仮想アドレスを使い、キャッシュエントリ内のタグには物理アドレスを格納しておく(仮想インデックス物理タグ方式)。
性能との関係
キャッシュとTLBのあるCPUが主記憶にアクセスするケースとして、以下の場合が考えられる。
- 最初のアクセス
- 命令キャッシュのミス時
- データキャッシュのミス時
- TLBミス時
必要な内容がキャッシュ上にあったとしても、TLB上にその仮想-物理変換情報がない場合、ページテーブルを辿る操作が生じるため、主記憶にアクセスすることになる。TLBミスが起きると性能が低下するため、仮想空間のあちこちにばらばらにアクセスするようなプログラムではTLBのスラッシングが起き、性能が低下する。そのためTLBをうまく機能させることが重要である。
TLBの多層化
キャッシュと同様、TLBを多層化することもでき、近年では一般化している。一次TLBは小さいが非常に高速で(フル・アソシアティブの場合もある)、二次TLBは大きいがやや低速である。命令とデータで一次TLBを別々に持つ場合(ITLBとDTLB)、二次TLBも命令とデータで別々に持つ場合などがある。
例えば、インテルのNehalemマイクロアーキテクチャでは、4ウェイ・セットアソシアティブの L1 DTLB(4KiBページでは64エントリ、2/4MiBページでは32エントリ)、2スレッドでスタティックに分割して使用する4KiBページで128エントリの L1 ITLB(4ウェイ・セットアソシアティブ)と2/4MiBページで14エントリの L1 ITLB(フルアソシアティブ)[1]、そして統合型の4KiBページ/512エントリの L2 TLB[2](4ウェイ・セットアソシアティブ[3])がある。
実装によっては、小さいページ用と大きなページ用にTLBを分けている場合がある。
TLBミス処理
TLBミスが発生したときの方式として、最近のアーキテクチャでは2種類の手法がある。
- MMUによるTLB管理の場合
- CPU自身が自動的にページテーブルを参照して、指定された仮想アドレスに対応するエントリがないか調べる(x86の場合は、CR3レジスタを使用)。エントリがあれば、必要な情報がTLBに読み込まれ、TLB参照を再実行し、TLBヒットとなってプログラムの実行は正常に続行される。CPU がページテーブルから対応するエントリを見つけられなかった場合ページフォールトが発生してオペレーティングシステムが例外処理を行う。その場合、必要なデータを物理メモリにロードし、ページテーブルを書き換えて例外を発生した仮想アドレスにデータをロードした物理アドレスを対応させ、プログラムの実行を再開する(詳しくはページフォールト参照)。この場合、TLBエントリの詳細なフォーマットはソフトウェアからは見えず、同じアーキテクチャであっても互換性を失わずにCPUの機種ごとに変更(最適化)することができる。
- ソフトウェアによるTLB管理の場合
- TLBミスにより "TLB miss" 例外が発生し、オペレーティングシステムがページテーブルを参照してソフトウェアによるアドレス変換が行われる。オペレーティングシステムは見つかった情報をTLBに格納し TLB miss 例外を発生した命令を再実行する。MMU による TLB 管理と同様、オペレーティングシステムがページテーブルから対応する変換情報を得られなかった場合、ページフォールトが発生し、同様に処理しなければならない。このようなアーキテクチャの命令セットにはTLBを操作する命令がある。そのため、TLBエントリのフォーマットが命令セットアーキテクチャ (ISA) の一部として明示されている[4]。MIPSアーキテクチャではソフトウェア管理のTLBになっている[5]。SPARC V9 アーキテクチャではMMUのない実装、ソフトウェア管理のTLBを持つMMU実装、ハードウェア管理のTLBを持つMMU実装の3種類を選択可能で[6]、UltraSPARCアーキテクチャではソフトウェア管理のTLBを指定している[7]。Itaniumアーキテクチャではハードウェア管理TLBとソフトウェア管理TLBを選択可能になっている[8]。
Alphaアーキテクチャでは、OSではなくPALcodeでTLBを管理する。PALcodeはプロセッサ固有で同時にOS固有であり、OSによってPALcodeが異なり、ページテーブルのフォーマットも異なる。ハードウェアに実装されたTLBのフォーマットやTLB操作命令は同一だが、PALcodeによってソフトウェアへの見せ方が異なる[9]。
TLB特性の例
- サイズ: 8 - 4,096 エントリ
- ヒット時にかかる時間: 0.5 - 1 クロックサイクル
- ミス時にかかる時間: 10 - 100 クロックサイクル
- ミス率: 0.01% - 1%
[10]
もし、ヒット時に 1クロックサイクルかかり、ミス時に 30クロックサイクルかかって、ミス率が1%だとすると、実際のメモリアクセスにかかる平均時間はクロックサイクルとなる。
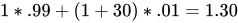
コンテキストスイッチ
コンテキストスイッチの際、仮想空間の切換えに伴ってTLBエントリの一部は不正となる。最も単純な対処法はTLB全体をフラッシュすることである。最近のCPUでは、TLBの個々のエントリがどのプロセスに対応するのかを示すことで効率を向上させている。従って、あるプロセスにごく短時間だけ切り替えて実行し、その前に動作していたプロセスに戻ったとき、元のTLBエントリがそのまま残っており、リロード時間を省ける可能性がある。
例えば Alpha 21264 では、それぞれのTLBエントリに「アドレス空間番号 (ASN)」が付属しており、プロセッサの制御レジスタに示されている現在のASNと一致するTLBエントリだけが妥当なエントリとして使用される。また、Pentium Pro ではCR4レジスタに page global enable (PGE) というフラグがあり、ページディレクトリまたはページテーブルのエントリにある global (G) フラグをセットすると、頻繁に使用するページに対応するTLBエントリがコンテキストスイッチ時の自動的なTLBフラッシュの際に消されなくなる。
ソフトウェア管理方式のTLBでは、コンテキストスイッチ時にTLBを選択的にフラッシュするようコーディングすることが可能だが、一部のハードウェア管理方式のTLB(例えば Intel 80386 のTLB)ではコンテキストスイッチ時に全TLBをフラッシュする。他のハードウェア管理方式TLB(例えば、Intel 80486 およびそれ以降のx86、ARMアーキテクチャなど)では、仮想アドレスを指定して個々のTLBエントリをフラッシュすることができる。
仮想化とx86のTLB
サーバ統合のための仮想化がよく行われるようになり、x86アーキテクチャでの仮想化を容易にする努力やx86での仮想機械の性能向上の努力がなされてきた[11][12]。その中でも最新といえるのがTLBの改良である。
従来、x86のTLBエントリはどのアドレス空間とも結び付けられていなかった。従って、コンテキストスイッチなどでアドレス空間が変わると、TLB全体をフラッシュする必要があった。x86のTLBは完全にハードウェア管理方式であり、低レイテンシで動作するよう設計されているため、TLBエントリにアドレス空間を識別するタグを導入するのは困難だった。2008年、インテルがNehalemで[13]、AMDがSVMで[14]、そのようなタグをTLBエントリに導入し、TLB参照時にそのタグをチェックするようハードウェアを改良した。今のところこのタグは十分利用されていないが、今後TLBエントリの属するアドレス空間の識別に使われる予定である。そうすればコンテキストスイッチ時に全TLBがフラッシュされることはなくなり、単に現在のアドレス空間を示す値を切り替えるだけになる。
脚注・出典
- “Inside Nehalem: Intel's Future Processor and System”. Real World Technologies. 2012年3月17日閲覧。
- “Intel Core i7 (Nehalem): Architecture By AMD?”. Tom's Hardware. 2010年11月24日閲覧。
- “Inside Nehalem: Intel's Future Processor and System”. Real World Technologies. 2010年11月24日閲覧。
- J. Smith and R. Nair. Virtual Machines: Versatile Platforms for Systems and Processes (The Morgan Kaufmann Series in Computer Architecture and Design). Morgan Kaufmann Publishers Inc., 2005.
- Welsh, Matt. “MIPS r2000/r3000 Architecture”. 2008年11月16日閲覧。 “If no matching TLB entry is found, a TLB miss exception occurs”
- SPARC International, Inc.. The SPARC Architecture Manual, Version 9. PTR Prentice Hall
- Sun Microsystems. UltraSPARC Architecture 2005 (Draft D0.9.2, 19 Jun 2008 ed.). Sun Microsystems
- Virtual Memory in the IA-64 Kernel > Translation Lookaside Buffer
- Compaq Computer Corporation. Alpha Architecture Handbook (Version 4 ed.). Compaq Computer Corporation
- David A. Patterson; John L. Hennessy (2009). Computer Organization And Design. Hardware/Software interface. 4th edition. Burlington, MA 01803, USA: Morgan Kaufmann Publishers. p. 503. ISBN 978-0-12-374493-7
- D. Abramson, J. Jackson, S. Muthrasanallur, G. Neiger, G. Regnier, R. Sankaran, I. Schoinas, R. Uhlig, B. Vembu, and J. Wiegert. Intel Virtualization Technology for Directed I/O. Intel Technology Journal, 10(03):179–192.
- Advanced Micro Devices. AMD Secure Virtual Machine Architecture Reference Manual. Advanced Micro Devices, 2008.
- G. Neiger, A. Santoni, F. Leung, D. Rodgers, and R. Uhlig. Intel Virtualization Technology: Hardware Support for Efficient Processor Virtualization. Intel Technology Journal, 10(3).
- Advanced Micro Devices. AMD Secure Virtual Machine Architecture Reference Manual. Advanced Micro Devices, 2008.
参考文献
- Virtual Translation Lookaside Buffer (インテルの特許)