漢字記述言語
漢字記述言語は、漢字(CJKV漢字)と、その構成要素の一覧、筆画(基本筆画・複合筆画)の一覧、筆順、方形のマス目中に各筆画が配される位置といった漢字の情報を、正確かつ完全に記述する目的で提案されているさまざまな言語である。ビットマップによる記述ではその性質上失われる情報が出てくるため、それを補うように設計されている。この付加情報は、UnicodeやISO/IEC 10646で同一コードポイントに包摂された異体字を区別したり、またUnicodeやISO/IEC 10646には規格化された符号化方法がない稀少字に対して他の形の符号化方法を与えたりするのに用いることができる。多くは楷書体および明朝体を対象とし、また、字の内部構成と類似字の相互参照情報を付与することによって、文字の検索をより簡単に行える、字の内部構造情報を与えることを狙いとしている。
CDL
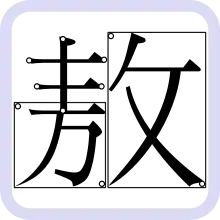
CDL(Chinese Character Description Language; 漢字字形記述言語)はTom BishopとRichard Cookが文林研究所のために共同開発した、XMLに基づくフォント技術であり、あらゆるCJK漢字を記述するために設計されているが、どんなグリフの記述にも適している。
このXMLベース宣言型言語で実際に定義されるのは、各部品(≒部首)の筆順のほか、より複雑な字の組み立てに使用する、定義済み部品の組み合わせである。この部品はそれ自体で文字であるものが多く、さらに組み立て要素としての機能ももつ。
背景は各辺128ピクセルの正方形をしている。その背景に、以下のように文字が定義される。
- 各種の筆画をSVG形式で描くことができる(50種類以上)。
- 基本的な部品は筆画をいくつか呼び出すことで構成される。この部品において、各筆画は左下と右上の隅を指定して記述される。これは変形(拡大、縮小など)することが可能である。基本部品は1,000以上存在する。
- 字は部品をいくつか呼び出すことで構成される。この字において、各部品は左下と右上の隅を指定して記述される。より複雑な字の一部をなす組み立て部品として使用する際には、部品が漢字の中で占める矩形の領域に適した形になるよう、変形(例えば横方向や縦方向の拡大や縮小)することが可能である。
このようにして、50ほどの筆画によって1,000以上の部品を組み立てることができ、そしてそれが今度は数万の漢字の記述の中に埋め込まれる。基本の50の筆画の一つに対して形の変更を加えると、それはその筆画を含む各字の中にも暗黙に適用される。同様に、部品に対する変更は、構成にその部品を使用している各文字の中にも暗黙に適用される。
T. BishopとR. Cookは以下のように説明している。
- 「ある漢字の画数は、他の漢字の画数と関連している場合が多い。ほとんどの漢字は、いくらかの部品から構成されており、各部品の画数が分かっていれば、その漢字の総画数がいくらかを計算するのは難しいことではない。従って、数千文字の漢字が既に定義されていれば、さらに数千文字も暗黙のうちに定義されている。」[1]
2003年春の時点で、すでに五万を超える漢字がCDLで記述できていた。2013年2月時点でCDLで記述できる漢字の数は8万6416文字である[2]。
HanGlyph
特殊な場合のみに使う漢字(外字など)を表現するための記述言語[3]。マークアップとして文章に設定しておくと、自動的に文字を切り替える。この言語自体は、筆画の方法などだけを表したシンプルなものである。試験的に実装されたソフトウェアは、MetaPostを使って文字を描画し、LaTeX文章に埋め込むことで実装している。この言語は1997年にWai Wongが発表し[4]、2003年のTeXユーザーによる会議の中で、MetaPostによる実装方法が公開された[5][6]。
漢字構成記述文字列 (IDS)
Unicode仕様書第12章[7]には、漢字構成記述文字(Ideographic Description Character)を用いた漢字構成記述文字列(Ideographic Description Sequence; IDS)の構文が定義されており、これは当該規格に含まれていない漢字を、すでに符号位置のある部品の組み合わせによって記述することを目的とする。U+2FF0からU+2FFBの領域にある12の特殊文字は前置演算子として働き、これにより他の漢字もしくは記述文字を組み合わせてより大きな字を構成する。
| 文字 | 符号位置番号 | Unicode文字名 | Unicode文字名の意味(参考) |
|---|---|---|---|
| ⿰ | U+2FF0 | Ideographic description character left to right | 漢字構成記述文字 左から右 |
| ⿱ | U+2FF1 | Ideographic description character above to below | 漢字構成記述文字 上から下 |
| ⿲ | U+2FF2 | Ideographic description character left to middle and right | 漢字構成記述文字 左から中および右 |
| ⿳ | U+2FF3 | Ideographic description character above to middle and below | 漢字構成記述文字 上から中および下 |
| ⿴ | U+2FF4 | Ideographic description character full surround | 漢字構成記述文字 完全な囲み |
| ⿵ | U+2FF5 | Ideographic description character surround from above | 漢字構成記述文字 上からの囲み |
| ⿶ | U+2FF6 | Ideographic description character surround from below | 漢字構成記述文字 下からの囲み |
| ⿷ | U+2FF7 | Ideographic description character surround from left | 漢字構成記述文字 左からの囲み |
| ⿸ | U+2FF8 | Ideographic description character surround from upper left | 漢字構成記述文字 左上からの囲み |
| ⿹ | U+2FF9 | Ideographic description character surround from upper right | 漢字構成記述文字 右上からの囲み |
| ⿺ | U+2FFA | Ideographic description character surround from lower left | 漢字構成記述文字 左下からの囲み |
| ⿻ | U+2FFB | Ideographic description character overlaid | 漢字構成記述文字 重なり |
例えば、「 」という字は「⿰書史」と記述できる。
この記述文字列は他の記述用の言語と比べ、筆画の位置や形状に関する詳しい情報は含んでいないという点で異なる。それ自体には、その記述する文字を実際に描画するのに必要な情報は示されていないのである。
しかし、使用するフォントにない、もしくはUnicode規格に存在しないといった理由で直接表示することができない漢字を読み手に説明するには、この記述文字列は有用である。
また偶然ではあるが、検索語を入れて結果を得る簡易的なインプットメソッドのような、文字検索の目的にも有用といえるだろう。
Unicodeのこれらの記述文字列の仕様は、以前のGBK規格に定められていた文字と構文に基づいている。
Matthew Skalaによるフリーソフトウェアパッケージ、IDSgrep[8][9]は、UnicodeのIDS構文を拡張し、文字検索用に追加機能を入れている。またKanjiVGのデータベースをIDSgrepの拡張IDSフォーマットに変換したり、関連ソフトウェア「作りましょう」のフォントファミリーによって生成されたEIDSファイルを検索したりする機能ももつ。
KanjiVG
KanjiVGは、フリー(CC・表示・継承)で公開されているSVGベースの日本語記述言語と、そのウィキシステムである。
SCML
2007年、CDLやHanGlyphのように数値的グリットによって表されていないXMLベースの漢字記述言語に代わるものとして、Structural Character Modeling Language(構造的文字モデリング言語)が提唱された。しかし、公開されたデータベースは原理的な部分のみで、Unicodeにある漢字すべてを表現することはまだできていない。
脚注
- Bishop, Tom, Cook, Richard & 2003 Oct. 31st, pp. 8–9, point n⁰12
- Wenlin Institute webpage for CDL
- “HanGlyph”. 2012年2月17日閲覧。
- Wong, Wai (April 1997). “HanGlyph – a Chinese Character Description Language”. Proceedings of the Seventeenth International Conference on Computer Processing of Oriental Languages, Hong Kong.
- Yiu, Candy L. K.; Wai Wong (July 2003). “Chinese Character Synthesis using METAPOST”. Proceedings of the 24th Annual Meeting and Conference of the TeX User Group, Hawaii, U.S.A..
- Wong, Wai; Candy L. K. Yiu; Kelvin, C. F. Ng (June 2003). “Typesetting Rare Chinese Characters in LaTeX”. Proceedings of the 14th European TeX Conference, Brest, France.
- Skala, Matthew (2015). “A Structural Query System for Han Characters”. International Journal of Asian Language Processing 23 (2): 127-159.
外部リンク
- CDL language from Wenlin Institute
- Bishop, Tom; Cook, Richard, CDL specification
- Bishop, Tom; Cook, Richard (2003 Oct. 31st), Specification for CDL
- Cook, Richard (2003, Oct. 26th), Chinese Character Description Languages
- Bishop, Tom (2007), A character description language for CJK, Multilingual, #91, Volume 18 Issue 7, pp. 62–8
- Digital Humanities Start-up Grant from the U.S. National Endowment for the Humanities
- SCML
- Peebles, Daniel G.; Balkcom, Devin (Advisor) (May 29, 2007), SCML: A Structural Representation for Chinese Characters, Technical Report TR2007-592, Dartmouth College, pp. 30
- HanGlyph