視覚と自然言語の融合研究
視覚と自然言語の融合研究[注釈 1](英語: Vision and Language[注釈 2])とは、コンピュータビジョンと自然言語処理を融合した研究分野である[12][5]。画像や動画からのキャプション生成[14]、画像や動画を対象とした質問応答(VQA)[15]などのタスクが含まれる。
1960年代からヒューマン・ロボット・コラボレーションの分野を中心に初期の研究が始められており[16][17]、1990年代ごろから画像検索[18]、2000年代から画像キャプション生成[19]の研究も始められた。2010年代に深層学習の適用によってコンピュータビジョンと自然言語処理が大きく発展したことに伴い、融合研究も発展を遂げている[16][20]。多くの研究が行われている一方で、データセットバイアスなどの研究課題も残されている[21][22]。
背景
視覚と自然言語の融合研究は、コンピュータビジョンと自然言語処理を融合した研究分野である[12][5]。2つの分野は独立して研究されてきたが、視覚と自然言語を組み合わせることにより、ヒューマンコンピュータインタラクション[23][20]、視覚障害者の支援[23][20][24]、ヒューマン・ロボット・コラボレーション[20][24]、自動運転[23]、ナビゲーション[23]、画像検索[20]といった分野への応用が期待されることもあり、融合研究が注目されるようになった[25][20]。
主な研究分野
視覚と自然言語の融合研究として以下のような分野が研究されている[38][18][1][4]。
自然言語処理のタスクの拡張
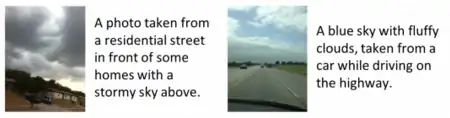
- 画像・動画の説明生成
- 画像や動画に対する説明を生成するタスクである[38][注釈 3]。この融合分野の代表的なタスクとされる[39]画像キャプション生成も含まれる[40]。
- 画像キャプション生成の研究は2000年代から行われており[19]、検索エンジンやソーシャルメディアなどで画像の説明を生成するために利用されている[41]。
- 画像・動画への質問応答(Visual Question Answering、VQA)
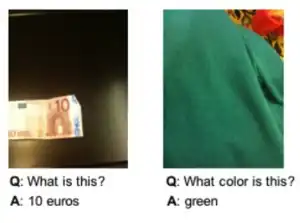
- 自然言語処理における質問応答は、人間の質問に対して回答するタスクである[42]。質問応答では、質問に回答するにあたって必要な情報を得るために、なんらかの文書を参照する場合もある[43]。質問応答が自然言語のみを使用するのに対して、VQAは質問応答タスクを拡張した、画像や動画に関する質問に答えるタスクである[38]。
- 未知の物体にも対応するようなVQAは2014年に研究が始められた[44]。
- 画像検索(Image Retrieval)
- 多数の画像の中から、画像を検索するタスクである[45]。キーワードや文章などの自然言語をクエリとして使用するタスク、画像をクエリとして類似している画像を検索するタスク、手書きの絵をクエリとするタスクなどが研究されている[46][47]。
- 従来は画像に人間がつけたキャプションなどを利用して検索を行っていたが、1990年代から画像に含まれる視覚情報も用いて検索を行う研究が行われるようになった[48][45]。検索エンジンでも使用されている[49][50]。
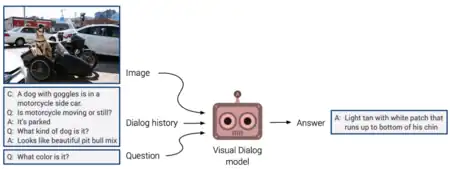
- 画像・動画に関する対話(Visual Dialog)
- 画像や動画に含まれる情報に対して、自然言語を用いて対話を行うタスクである[38]。例えば、人間が対話システムに画像の内容に関する複数の質問を問いかけるという対話において、対話システムは過去の対話内容も考慮して回答する必要がある[51]。
- Visual Dialogは2017年に提案されて研究が始まった[52]。
- 画像の参照表現(Visual Referring Expression)の理解・生成
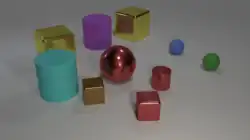
- 参照表現(Referring Expression)とは「左の三つの玉のうちの一番右の玉」のように複数の物体の中から特定の物体を識別するための言語表現である[53]。視覚との融合分野では、自然言語で与えられた参照表現に対応する物体を画像中で示したり、画像中の物体に対応する参照表現を生成するタスクが研究されている[54]。
- 参照表現生成の研究は自然言語処理の分野で1970年代から行われているが[55]、2010年代まで画像などに含まれる視覚情報を直接使うような手法はほとんど研究されていなかった[56][57]。深層学習を用いた画像の参照表現の理解と生成の最初の研究は2016年に発表され[58]、画像から直接の参照表現の理解・生成を行う研究が始まった[57]。
コンピュータビジョンのタスクの拡張
- 文章に対する画像生成
- 与えられた文章に対応した画像を生成するタスクである[38][注釈 4]。
- 敵対的生成ネットワーク(GAN)の登場に伴い、2016年に文章から画像を生成する最初の研究が発表された[67]。
- Visual Reasoning
- 画像分類や物体検出を拡張したタスクであり[38]、画像や動画に含まれる視覚情報を理解するタスクである[68]。一例として、画像に含まれる複数の物体同士の関係性などを理解するタスクなどが含まれる[69][70]。Visual Reasoningは視覚情報に対する質問に回答するための過程として定義されることもある[71]。すなわち、VQAやVisual Dialogのモデルは(明示的に設計されていなくても)Visual Reasoningを行なっていることになる[71]。Visual Reasoningの手法を評価するために、VQAを用いることも一般的である[70]。
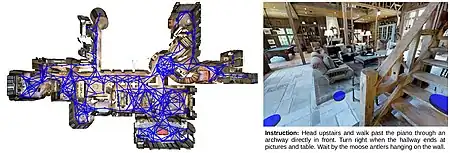
- 初期の研究は1960年代から行われている[69]。
歴史
黎明期(1960年代以降)
1968年から始められたSHRDLUというプロジェクトが、視覚と自然言語の融合における最初期の研究のひとつとされている[16][17]。SHRDLUは人間が自然言語で指示をすることで、コンピュータ内の仮想空間の積み木を操作できるコンピュータプログラムである[17]。これ以降の視覚と自然言語の融合研究では、ロボットを自然言語による対話で操作するという分野が多く研究されてきた[16]。
深層学習以前(1990年代〜2000年代)
画像検索も視覚と自然言語の融合研究における最初期のタスクのひとつである[18]。従来は画像に人間がつけたキャプションを利用していたが、1990年代から画像の視覚情報も用いて検索を行う研究が行われるようになった[45][74]。
画像キャプション生成は2000年代ごろから研究が行われており、主にテンプレートを用いた手法が提案されていた[19]。テンプレートを用いて文章を生成するためにSIFTやHOGなどの局所画像特徴量[75]に対してサポートベクターマシン(SVM)などの分類器を適用するなどの手法が提案された[76][77]。
深層学習の適用(2010年代以降)
2010年代の深層学習の適用によって、画像と自然言語処理の融合分野も大きな発展を遂げた[16][20]。VQA(2014年)[注釈 5]、マルチモーダル機械翻訳(2016年)[61]、Visual Dialog(2017年)[52]、視覚と言語を用いたナビゲーション(2017年)[73]といったタスクの研究も2010年代に始まった。
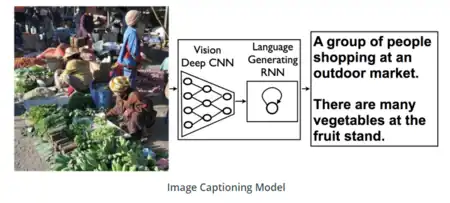
深層学習が適用されるようになってからは、主に畳み込みニューラルネットワーク(CNN)を用いて画像や動画の特徴量を、回帰型ニューラルネットワーク(RNN)を用いて自然言語の特徴量を抽出して、2種類の特徴量を統合する手法が研究されてきた[78]。2019年からはTransformer[79][80]という共通のモデルを用いる手法が研究されている[81][82]。
手法
視覚情報と自然言語情報の統合(2018年ごろまでの主流)
視覚と自然言語の融合研究の手法について、視覚情報や自然言語の特徴量を得る機構などには共通点が多く[83]、2018年ごろまで[82]の多くの手法は、(1)視覚情報処理、(2)自然言語処理、(3)二つの情報の統合を行う3個のサブシステムを持っていた[78]。
視覚情報処理には、かつてはSIFTなどの局所画像特徴量が用いられていたが[76][75]、深層学習が適用され始めてからは主にCNNが使用されてきた[78]。2017年まではCNNが出力する特徴量をそのまま利用するモデルが多かったが、バウンディングボックスやグラフ構造を中間表現として利用する研究も行われるようになった[78]。
自然言語処理には単語ベクトルが使われることが多かったが[38]、深層学習が適用され始めてからは主にRNNで得られる文章全体の特徴量が使用されてきた[78]。
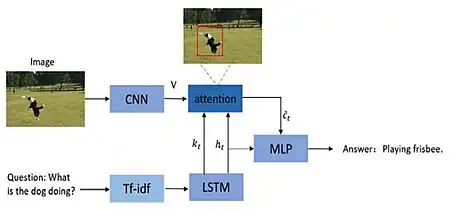
これらの手法によって得られた画像や動画と自然言語の情報を統合するための手法は、タスクごとに様々なものが利用されている[78]。CNNやRNNから得られた特徴量ベクトルを統合する最も単純な方法は、二つのベクトルを連結したりアダマール積をとることである[78]。より高度な手法として、注意機構(Attention)という手法を適用して、画像や自然言語からそれぞれのクエリに対して重要な情報を自動的に選択して利用することが提案されている[78]。
統合的な事前学習(2019年以降)
事前学習とは、機械学習のモデルを大規模なデータセットで学習することで、さまざまなタスクに用いることができる特徴量を抽出できるモデルを学習する手法である[84]。大規模なデータセットで事前学習を行ったのちに、比較的小規模のデータセットを用いて個別のタスクにチューニングを行うことで、高い性能を持つモデルを学習できることが知られている[84]。コンピュータビジョンにおいてはCNNをImageNetなどの大規模なデーセットで事前学習することは広く行われてきたが[84]、RNNを用いた自然言語処理で事前学習を行うことは少なかった[85][注釈 6]。2017年に発表された自然言語処理の新しいモデルであるTransformer[79]に対して事前学習を行う手法が2018年に提案され[86]、自然言語処理においても文章全体について事前学習を行う研究が行われるようになった(BERTなど)[87]。2018年には動画にTransformerを適用する研究が提案され、2020年には画像にTransformerを適用する研究も始められた(Vision Transformer)[88]。
視覚と自然言語の融合研究においても、2019年からTransformerを用いて画像・動画と自然言語の事前学習を同時に行う研究が行われている[82]。
主なタスクの研究・評価手法
視覚と自然言語の融合研究のタスクには共通点があるが[83][78]、タスクごとに異なる手法が研究されている[89]。ここでは主なタスクの手法と評価手法を紹介する。
画像・動画の説明生成
- 画像キャプション生成の手法
- 研究が始められた2000年代ごろには主にテンプレートを用いた手法が提案されていた[19]。テンプレートを用いて文章を生成するためにSIFTやHOGなどの局所画像特徴量[75]に対してSVMなどの分類器を適用するなどの手法が提案された[76][77]。
- 深層学習を用いた手法が発展した2010年代には、CNNとRNNを用いる方法が一般的になった[77]。さまざまなモデルが提案されているが、単純かつ一般的に使用されている手法としては教師あり学習を用いたエンコーダ・デコーダモデルがある[90]。これは、CNNを用いて画像特徴量を抽出して、画像特徴量をRNNに入力してキャプションを生成するという手法である[91]。2019年には画像と自然言語の両方にTransformerを使用する手法も提案されている[92]。
画像・動画への質問応答(VQA)
- 手法
- 2014年に研究が始められた当初の手法は、あらかじめ定義された形式の回答に限定されたものだったが、2015年には回答の形式を限定しないような質問にも対応できるモデルが提案された[96]。2015年に提案されたモデルのひとつは、CNNで抽出された画像の特徴量ベクトルと質問文章の単語ベクトルの両方をエンコーダのRNN(LSTM)に入力することで特徴量を統合し、デコーダのRNNで回答を生成する手法である[97]。同時期には、特徴量の統合の方法を変更したり、注意機構(Attention)の適用や、データベースを利用する方法など、様々な手法が提案されている[97]。2019年には自然言語処理にTransformerを使用するモデルや[98]、Transformerを用いて画像と自然言語の特徴量を統合的に事前学習する手法が提案されている[99]。
画像検索(Image Retrieval)
- 手法
- さまざまな種類のクエリに対する画像検索が研究されているが[46][47]、文章か画像をクエリとする研究が多く研究されている[102]。
- 文章をクエリとする検索について、2019年でもウェブ検索では人間がつけたキャプションなどの自然言語の情報を利用しているとされている[102]。キャプションがない画像も検索するために、画像キャプション生成などを用いて[41]自動的にアノテーションを行う手法を適用することが研究されている[103]。
- 人間がつけたキャプションなどを利用しない方法として、1990年代から画像をクエリとして類似する画像を検索する研究が行なわれている[103][104]。画像をクエリとした画像検索は、画像から特徴量を抽出して類似度を評価することで行なわれる[105]。初期の研究として色、形、質感などを特徴量として使用する方法が研究されてきたが、それだけでは画像が表す意味の類似性を比較することができないことが課題だった[104]。そのため、深層学習が適用される以前から、画像全体の意味も表すような特徴量も併用する試みが研究されてきた[104]。深層学習を使用した方法も数多く提案されており、CNNを利用して画像検索に有用な特徴量を抽出する研究が行なわれている[106]。
- 評価手法
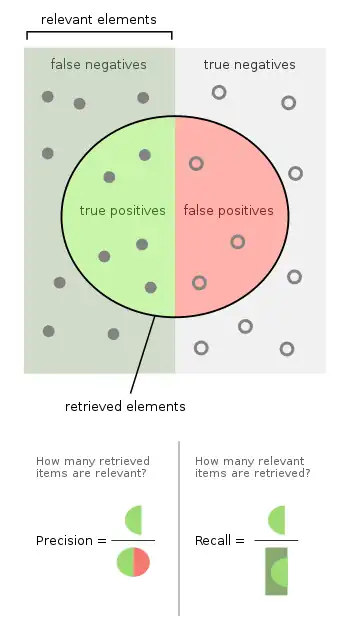
- 画像検索には情報検索の評価手法が用いられる[107]。評価手法として様々なものがあり、想定される適用先などによって使い分けることが求められる[108]。広く用いられているのは適合率(Precision)と再現率(Recall)、およびF値である[108]。ここで、検索結果の上位k個の画像を「検出された」と判定するとする[108]。また、評価の際には、検出されるべき正解の画像(複数の場合もある)が分かっているとする[108]。下式のように、適合率(P)は検出された画像の中で、正解の画像(tp)の割合で表される(fpは誤って検出された画像の数)[108]。再現率(R)は検出されるべき正解の画像の中で、実際に検出された画像(tp)の割合で表される(fnは正解の画像だが、検出されなかった画像の数)[108]。
- F値は適合率と再現率の調和平均で求められる[108]。
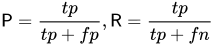
データセット
大規模なデータセットを用いて学習することは、深層学習モデルの汎化性能を高める重要な要素のひとつである[111]。視覚と自然言語の融合研究においても大規模なデータセットは重要な役割を果たしており、モデルの学習と評価に不可欠な存在である[16]。写真の共有サイトであるFlickrなどから提供される画像データとクラウドソーシングによるアノテーションによって、大規模なデータセットを作ることが可能になった[16]。このような既存の画像を収集するだけではなく、データセットのために作成されることもある[73]。
さまざまなデータセットが提案されているが、データセットのサイズ(含まれる画像や文章の数)、画像の質や多様性、文章の長さ、文章に含まれる単語や構文の多様性、アノテーションの豊富さなどの異なる性質を持っており[112]、それぞれのデータセットに利点と欠点がある[16]。
本節では主なデータセットを紹介する[注釈 7]。
画像・動画の説明生成
データセットには画像と説明文が含まれるが、データセットによってデータの数や質、収集方法などが異なる[114]。
キャプション付き画像データセット
| 名称 | 発表年 | 画像の枚数 | 各画像のキャプション数 | 特徴 | 出典 |
|---|---|---|---|---|---|
| SBU Captioned Photo Dataset | 2011 | 1,000,000 | 1 | Flickrから集められた写真で、ユーザがつけたキャプションを利用している。 | [115] |
| Flickr 30K Images | 2014 | 31,014 | 5 | Flickrから集められた写真に対して、クラウドソーシングでキャプションを付けている。 | [116] |
| Microsoft COCO Dataset | 2014 | 123,287 | 5 | Flickrから集められた写真に対して、クラウドソーシングでキャプションを付けている。広く利用されているデータセット[117]。 | [118] |
説明付き動画データセット
| 名称 | 発表年 | 動画の数 | 動画の合計時間 | 文章の数 | 特徴 | 出典 |
|---|---|---|---|---|---|---|
| Microsoft Research Video Description Corpus | 2011 | 1,970 | 5.3時間 | 70,028 | YouTubeの動画に、クラウドソーシングで説明をつけている。複数言語の説明がつけられている。 | [119] |
画像への質問応答
異なる特徴を持ったさまざまなデータセットが提案されている。実世界の画像を用いたデータセットが良く使われているが[120]、画像認識の能力ではなく意味を理解できているかの評価に注目するために、クリップアートで作成された絵を用いたデータセットも提案されている[121]。初期のデータセットは画像中の情報を理解できれば質問に答えられるものであったが、2015年に発表されたKB-VQAというデータセットなどは、画像中の情報だけでは質問に正しく回答することはできず、外部データベースの知識を用いることが求められる[121]。2017年に発表されたVisual Genomeというデータセットでは、画像のシーングラフ(物体をノード、物体同士の関係(位置関係など)をエッジとするグラフ[122])が与えられている[123]。
| 名称 | 発表年 | 画像の枚数 | 質問の数 | 回答の数 | 説明 | 出典 |
|---|---|---|---|---|---|---|
| Visual Question Answering Dataset (v1.0) | 2015 | 204,721 + 50,000 | 614,163 + 150,000 | 6,141,630 + 1,500,000 | MS COCOの画像(204,721枚)とクリップアートで作成された絵(50,000枚)に対して、クラウドソーシングで質問と回答がつけられている。 | [124] |
課題
データセットバイアス
データセットバイアスとは、機械学習モデルの学習に使用したときに誤った結論を導く可能性がある、データセットの偏りのことである[125]。例えば、画像データセットを用いて「自動車」を認識する機械学習モデルを学習するときに、ImageNetというデータセットでは「自動車」というラベルにスポーツカーを多く含むため、自家用車の検出性能が低くなってしまうという問題が起こることがある[126]。逆に、学習データとテストデータは多くの場合は同じ条件で集められているため、学習データを記憶するだけでテストデータにも対応できてしまい、実際の性能よりも高く評価されてしまうという問題が起こることもある[21]。
データセットバイアスはコンピュータビジョンや自然言語処理のそれぞれの分野でも問題となるが、両方の分野を対象とする融合研究ではより深刻な影響を受けるとされている[21][127]。一例として、VQAのデータセットにおいて、質問に対する回答に偏りがあると画像を使わなくても一定の精度を達成できてしまうことが知られている[21][128]。例えばデータセットに「画像中に〜がありますか」という形式の質問が複数あり、答えとして「はい」が多いという偏りがあるとする[21]。機械学習モデルは画像の内容を確認して答えることが期待されるが、自然言語の質問だけを見て「画像中に〜がありますか」という形式の質問には常に「はい」と答えるように学習をされてしまうことが起こり得る[21][128]。
解決方法としてデータセットからバイアスを取り除く方法が研究されているが、大規模なデータセットにおいてあらゆる要素のバイアスを取り除くことは不可能に近く、未解決の問題とされている[21]。
評価の難しさ
評価手法はコンピュータビジョンと自然言語処理の各分野においても課題のひとつであるが、融合研究においてはさらに大きな問題となっているとされている[22]。特に自然言語生成に関係するタスクにおける評価は難しいとされる[22][129][130]。例えば画像キャプション生成において「男性が木の横を歩いている」と「男が木のそばを散歩している」という二つの文章はほとんど同じ意味を表しているが、自動的に類似度の評価を行うことは難しい[22]。また、VQAにおいて「鳥」という答えが正解とされている問題に対して、「鷹」という答えが正しいのかどうかを自動的に評価することは難しい[22]。
評価手法を改善する研究は行われているが、未解決の問題となっている[22]。
脚注
注釈
- 日本語での表記は複数存在し、「視覚と自然言語の融合研究」[1]、「視覚と言語の融合研究」[2][3]、「画像と自然言語処理の融合研究」[4]、「CVとNLPの融合研究」[5]などの他に"Vision and Language"と英語のままで呼ばれることもある[6][7]。
- "Vision and Language"[8][9][10]の他に"Language and Vision"[11]など表記に揺らぎはある。
- 自然言語処理分野において、与えられた文章の次の文章を生成する「条件付き言語生成」は広く研究されているが、これを拡張した、与えられた画像や動画に対して「条件付き言語生成」をするというタスクとして捉えることもできる[38]。
- コンピュータビジョンで画像に対する画像の生成(白黒写真からカラー写真の生成など[66])などが研究されているが、これを自然言語との融合分野に拡張したタスクとして捉えることもできる[38]。
- 未知の物体なども対象とした(open-world)手法として初めて提案されたのがMalinowski et al. (2014)[10]である[44]。
- 自然言語処理分野においては、単語ベクトルを事前学習することは広く研究されてきた[85]。
- サーベイ論文[113][9]で挙げられているデータセットを中心に取り上げる。
出典
- 牛久祥孝. “【記事更新】私のブックマーク「視覚と自然言語の融合研究(Integrating Vision and Language)」 – 人工知能学会 (The Japanese Society for Artificial Intelligence)”. 人工知能学会. 2022年3月24日閲覧。
- “NL研・CVIM研・PRMU研の合同研究会:第248回自然言語処理研究会 発表募集”. 情報処理学会 自然言語処理研究会 (NL) (2021年2月9日). 2022年3月24日閲覧。
- “【第48回AIセミナー】「マルチモーダル情報の統合理解の最前線」”. 人工知能研究センター. 2022年3月24日閲覧。
- “AI白書2017:IPA 独立行政法人 情報処理推進機構”. 情報処理推進機構. p. 42. 2022年3月24日閲覧。
- 一般社団法人情報処理学会. “第247回NL研究発表会-情報処理学会”. www.ipsj.or.jp. 2022年3月24日閲覧。
- 井尻, 善久; 牛久, 祥孝; 片岡, 裕雄; 藤吉, 弘亘, eds. (2021). コンピュータビジョン最前線 Winter 2021. 共立出版. p. 78.
- 品川, 政太朗「Vision and Languageと分野を取り巻く深層学習手法の紹介」『研究報告コンピュータビジョンとイメージメディア(CVIM)』2021-CVIM-226第15号、2021年5月13日、1–1頁、ISSN 2188-8701。
- “Workshop on Vision and Language - ACL Anthology”. ACL Anthology. ACL. 2022年3月24日閲覧。
- Mogadala, Kalimuthu & Klakow 2021.
- Antol, Stanislaw; Agrawal, Aishwarya; Lu, Jiasen; Mitchell, Margaret; Batra, Dhruv; Lawrence Zitnick, C.; Parikh, Devi (2015). “VQA: Visual Question Answering”. Proceedings of the IEEE International Conference on Computer Vision (ICCV): 2425–2433.
- “CVPR 2015 Language and Vision Workshop | The Center for Brains, Minds & Machines”. Center for Brain, Minds & Machines. 2022年3月24日閲覧。
- Mogadala, Kalimuthu & Klakow 2021, p. 1183.
- Ferraro 2015, p. 210.
- [1][4][13]
- [1][10][13]
- Ferraro 2015, p. 207.
- Terry Winograd. “SHRDLU”. 2022年3月24日閲覧。
- Kafle 2019, 2.1. Tasks in V&L Research.
- Wang 2021, p. 2.
- Kafle 2019, 1. Introduction.
- Kafle 2019, 3.1. Dataset Bias.
- Kafle 2019, 3.2. Evaluation Metrics.
- Mogadala, Kalimuthu & Klakow 2021, p. 1184.
- Fern, Sonia. “The intersection of vision and language” (英語). phys.org. 2022年4月9日閲覧。
- Mogadala, Kalimuthu & Klakow 2021, pp. 1183–1184.
- Sonka 2008, p. 1.
- Huang, T (1996) (英語). Computer Vision: Evolution And Promise. doi:10.5170/CERN-1996-008.21.
- “コンピューター ビジョンとは | Microsoft Azure”. Microsoft. 2022年4月8日閲覧。
- Mogadala, Kalimuthu & Klakow 2021, p. 1185.
- Sonka 2008, p. 385.
- Cao, Yang-Jie; Jia, Li-Li; Chen, Yong-Xia; Lin, Nan; Yang, Cong; Zhang, Bo; Liu, Zhi; Li, Xue-Xiang et al. (2019). “Recent Advances of Generative Adversarial Networks in Computer Vision”. IEEE Access 7: 14985–15006. doi:10.1109/ACCESS.2018.2886814. ISSN 2169-3536.
- Wang, Zhengwei; She, Qi; Ward, Tomás E. (2022-03-31). “Generative Adversarial Networks in Computer Vision: A Survey and Taxonomy” (英語). ACM Computing Surveys 54 (2): 1–38. doi:10.1145/3439723. ISSN 0360-0300.
- Jurafsky 2009, p. 1.
- Eisenstein 2019, p. 1.
- Jurafsky 2009, p. 737.
- Eisenstein 2019, p. 424.
- Eisenstein 2019, p. 431.
- Mogadala, Kalimuthu & Klakow 2021, p. 1187.
- Baltrušaitis 2019, p. 424.
- Mogadala, Kalimuthu & Klakow 2021, p. 1190.
- Hossain 2019, p. 1.
- Jurafsky 2009, p. 779.
- Jurafsky 2009, p. 780.
- Wu 2017, p. 3.
- Mezaris, V.; Kompatsiaris, I.; Strintzis, M.G. (2003-09). “An ontology approach to object-based image retrieval”. Proceedings 2003 International Conference on Image Processing (Cat. No.03CH37429) 2: II–511. doi:10.1109/ICIP.2003.1246729.
- Datta 2008, pp. 11–12.
- Latif 2019, p. 3.
- Datta 2008, p. 4.
- Kaput, Mike. “AI in Search Engines: Everything You Need to Know” (英語). Marketing AI Institute. 2022年4月9日閲覧。
- “Google Search By Image: Use A Snapshot As Your Search Query” (英語). TechCrunch. 2022年4月9日閲覧。
- Mogadala, Kalimuthu & Klakow 2021, p. 1246.
- Das, Abhishek; Kottur, Satwik; Gupta, Khushi; Singh, Avi; Yadav, Deshraj; Moura, Jose M. F.; Parikh, Devi; Batra, Dhruv (2017). Visual Dialog. pp. 326–335.
- 船越, 孝太郎、渡辺, 聖、栗山, 直子、徳永, 健伸「知覚的群化に基づく参照表現の生成」『自然言語処理』第13巻第2号、2006年、79–97頁、doi:10.5715/jnlp.13.2_79。
- Mogadala, Kalimuthu & Klakow 2021, p. 1216.
- Kazemzadeh, Sahar; Ordonez, Vicente; Matten, Mark; Berg, Tamara (2014-10). “ReferItGame: Referring to Objects in Photographs of Natural Scenes”. Proceedings of the 2014 Conference on Empirical Methods in Natural Language Processing (EMNLP) (Doha, Qatar: Association for Computational Linguistics): 787–798. doi:10.3115/v1/D14-1086.
- Krahmer 2012, p. 207.
- Mao, Junhua; Huang, Jonathan; Toshev, Alexander; Camburu, Oana; Yuille, Alan; Murphy, Kevin (2016-06). “Generation and Comprehension of Unambiguous Object Descriptions”. 2016 IEEE Conference on Computer Vision and Pattern Recognition (CVPR) (Las Vegas, NV, USA: IEEE): 11–20. doi:10.1109/CVPR.2016.9. ISBN 978-1-4673-8851-1.
- Qiao 2021, p. 4427.
- 寺中, 元希; 斎藤, 博昭 (2015). “含意関係認識におけるベクトル空間モデルの適用”. 自然言語処理学会 21: 924.
- Mogadala, Kalimuthu & Klakow 2021, p. 1241.
- Specia, Lucia; Frank, Stella; Sima'an, Khalil; Elliott, Desmond (2016-08). “A Shared Task on Multimodal Machine Translation and Crosslingual Image Description”. Proceedings of the First Conference on Machine Translation: Volume 2, Shared Task Papers (Berlin, Germany: Association for Computational Linguistics): 543–553. doi:10.18653/v1/W16-2346.
- “CLEVR: A Diagnostic Dataset for Compositional Language and Elementary Visual Reasoning”. cs.stanford.edu. 2022年3月25日閲覧。
- CLEVR Dataset Generation, Meta Research, (2022-03-16) 2022年3月25日閲覧。
- “CLEVR: A Diagnostic Dataset for Compositional Language and Elementary Visual Reasoning”. cs.stanford.edu. 2022年3月25日閲覧。
- CLEVR Dataset Generation, Meta Research, (2022-03-16) 2022年3月25日閲覧。
- Isola, Phillip; Zhu, Jun-Yan; Zhou, Tinghui; Efros, Alexei A. (2017-07). “Image-to-Image Translation with Conditional Adversarial Networks”. 2017 IEEE Conference on Computer Vision and Pattern Recognition (CVPR): 5967–5976. doi:10.1109/CVPR.2017.632.
- Mogadala, Kalimuthu & Klakow 2021, p. 1258.
- Mogadala, Kalimuthu & Klakow 2021, p. 1232.
- Bakhtin, Anton; van der Maaten, Laurens; Johnson, Justin; Gustafson, Laura; Girshick, Ross (2019). “PHYRE: A New Benchmark for Physical Reasoning”. Advances in Neural Information Processing Systems (Curran Associates, Inc.) 32.
- Johnson, Justin; Hariharan, Bharath; Van Der Maaten, Laurens; Hoffman, Judy; Fei-Fei, Li; Zitnick, C. Lawrence; Girshick, Ross (2017-10). “Inferring and Executing Programs for Visual Reasoning”. 2017 IEEE International Conference on Computer Vision (ICCV): 3008–3017. doi:10.1109/ICCV.2017.325.
- He 2021, p. 2.
- Zieliński, P.; Markowska-Kaczmar, U. (2021-10-01). “3D robotic navigation using a vision-based deep reinforcement learning model” (英語). Applied Soft Computing 110: 107602. doi:10.1016/j.asoc.2021.107602. ISSN 1568-4946.
- Anderson, Peter; Wu, Qi; Teney, Damien; Bruce, Jake; Johnson, Mark; Sunderhauf, Niko; Reid, Ian; Gould, Stephen et al. (2018-06). “Vision-and-Language Navigation: Interpreting Visually-Grounded Navigation Instructions in Real Environments”. 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition (Salt Lake City, UT: IEEE): 3674–3683. doi:10.1109/CVPR.2018.00387. ISBN 978-1-5386-6420-9.
- Datta 2008, p. 5.
- 庄野逸 (2013). “局所画像特徴量 ~ SIFT, HOG を題材に~”. 映像情報メディア学会誌 67 (3): 256~258.
- Farhadi, Ali; Hejrati, Mohsen; Sadeghi, Mohammad Amin; Young, Peter; Rashtchian, Cyrus; Hockenmaier, Julia; Forsyth, David (2010). Daniilidis, Kostas; Maragos, Petros; Paragios, Nikos. eds. “Every Picture Tells a Story: Generating Sentences from Images” (英語). Computer Vision – ECCV 2010 (Berlin, Heidelberg: Springer): 15–29. doi:10.1007/978-3-642-15561-1_2. ISBN 978-3-642-15561-1.
- Hossain 2019, p. 2.
- Kafle 2019, 2.2. V&L Algorithms.
- Vaswani, Ashish; Shazeer, Noam; Parmar, Niki; Uszkoreit, Jakob; Jones, Llion; Gomez, Aidan N; Kaiser, Łukasz; Polosukhin, Illia (2017). “Attention is All you Need”. Advances in Neural Information Processing Systems (Curran Associates, Inc.) 30.
- Parmar, Niki; Vaswani, Ashish; Uszkoreit, Jakob; Kaiser, Lukasz; Shazeer, Noam; Ku, Alexander; Tran, Dustin (2018-07-03). “Image Transformer” (英語). International Conference on Machine Learning (PMLR): 4055–4064.
- Mogadala, Kalimuthu & Klakow 2021, p. 1270.
- Uppal 2022, p. 161.
- Mogadala, Kalimuthu & Klakow 2021, p. 1189.
- He, Kaiming; Girshick, Ross; Dollar, Piotr (2019-10). “Rethinking ImageNet Pre-Training”. 2019 IEEE/CVF International Conference on Computer Vision (ICCV) (Seoul, Korea (South): IEEE): 4917–4926. doi:10.1109/ICCV.2019.00502. ISBN 978-1-7281-4803-8.
- Qiu 2020, p. 1872.
- Devlin, Jacob; Chang, Ming-Wei; Lee, Kenton; Toutanova, Kristina (2019). “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding” (英語). Proceedings of the 2019 Conference of the North (Minneapolis, Minnesota: Association for Computational Linguistics): 4171–4186. doi:10.18653/v1/N19-1423.
- Qiu 2020, p. 1873.
- Han 2022, p. 1.
- Uppal 2022, p. 149.
- Hossain 2019, pp. 4, 11.
- Hossain 2019, pp. 11.
- Uppal 2022, p. 153.
- Mogadala, Kalimuthu & Klakow 2021, p. 1198.
- Sharma 2020, p. 327.
- Zhang, Jianing; Wu, Zhaochang; Zhang, Huajie; Chen, Yunfang (2020-10-01). “Visual Question Answering Based on Question Attention Model”. Journal of Physics: Conference Series 1624 (2): 022022. doi:10.1088/1742-6596/1624/2/022022. ISSN 1742-6588.
- Qi 2017, p. 22.
- Qi 2017, p. 23.
- Uppal 2022, p. 155.
- Zhou, Luowei; Palangi, Hamid; Zhang, Lei; Hu, Houdong; Corso, Jason; Gao, Jianfeng (2020-04-03). “Unified Vision-Language Pre-Training for Image Captioning and VQA”. Proceedings of the AAAI Conference on Artificial Intelligence 34 (07): 13041–13049. doi:10.1609/aaai.v34i07.7005. ISSN 2374-3468.
- Wu 2017, p. 22.
- Wu 2017, p. 30.
- Latif 2019, p. 1.
- Latif 2019, p. 2.
- Kapoor 2021, p. 29562.
- Kapoor 2021, p. 29561.
- Kapoor 2021, pp. 29563–29571.
- Datta 2008, p. 52.
- Latif 2019, p. 17.
- Mogadala, Kalimuthu & Klakow 2021, p. 1261.
- Li, Bowen; Qi, Xiaojuan; Lukasiewicz, Thomas; Torr, Philip (2019). “Controllable Text-to-Image Generation”. Advances in Neural Information Processing Systems (Curran Associates, Inc.) 32.
- Goodfellow 2016, p. 19.
- Ferraro 2015, p. 208.
- Ferraro 2015.
- Mogadala, Kalimuthu & Klakow 2021, p. 1193.
- “Im2Text: Describing Images Using 1 Million Captioned Photographs”. Vicente Ordonez. 2022年3月25日閲覧。
- Young, Peter; Lai, Alice; Hodosh, Micah; Hockenmaier, Julia (2014). “From image descriptions to visual denotations: New similarity metrics for semantic inference over event descriptions”. Transactions of the Association for Computational Linguistics 2: 67–78. doi:10.1162/tacl_a_00166.
- Mogadala, Kalimuthu & Klakow 2021, p. 1195.
- Lin, Tsung-Yi; Maire, Michael; Belongie, Serge; Hays, James; Perona, Pietro; Ramanan, Deva; Dollár, Piotr; Zitnick, C. Lawrence (2014). Fleet, David; Pajdla, Tomas; Schiele, Bernt et al.. eds. “Microsoft COCO: Common Objects in Context” (英語). Computer Vision – ECCV 2014 (Cham: Springer International Publishing): 740–755. doi:10.1007/978-3-319-10602-1_48. ISBN 978-3-319-10602-1.
- Chen, David; Dolan, William (2011-06). “Collecting Highly Parallel Data for Paraphrase Evaluation”. Proceedings of the 49th Annual Meeting of the Association for Computational Linguistics: Human Language Technologies (Portland, Oregon, USA: Association for Computational Linguistics): 190–200.
- Wu 2017, p. 28.
- Wu 2017, p. 33.
- He 2021, p. 5.
- Wu 2017, p. 34.
- “Visual Question Answering” (英語). Visual Question Answering. 2022年3月25日閲覧。
- Tommasi, Tatiana; Patricia, Novi; Caputo, Barbara; Tuytelaars, Tinne (2017), “A Deeper Look at Dataset Bias”, in Csurka, Gabriela (英語), Domain Adaptation in Computer Vision Applications, Springer International Publishing, p. 39, doi:10.1007/978-3-319-58347-1_2, ISBN 978-3-319-58347-1
- Torralba, Antonio; Efros, Alexei A. (2011-06). “Unbiased look at dataset bias”. CVPR 2011: 1521–1528. doi:10.1109/CVPR.2011.5995347.
- Margaret Mitchell. “Bias in the Vision and Language of Artificial Intelligence”. 2022年4月8日閲覧。
- Antol, Stanislaw; Agrawal, Aishwarya; Lu, Jiasen; Mitchell, Margaret; Batra, Dhruv; Zitnick, C. Lawrence; Parikh, Devi (2015-12). “VQA: Visual Question Answering”. 2015 IEEE International Conference on Computer Vision (ICCV) (Santiago, Chile: IEEE): 2425–2433. doi:10.1109/ICCV.2015.279. ISBN 978-1-4673-8391-2.
- Iqbal 2020, p. 12.
- Novikova, Jekaterina; Dušek, Ondřej; Cercas Curry, Amanda; Rieser, Verena (2017). “Why We Need New Evaluation Metrics for NLG” (英語). Proceedings of the 2017 Conference on Empirical Methods in Natural Language Processing (Copenhagen, Denmark: Association for Computational Linguistics): 2241–2252. doi:10.18653/v1/D17-1238.
参考文献
書籍
- Goodfellow, Ian; Bengio, Yoshua; Courville, Aaron (2016-11-18) (英語). Deep Learning. Cambridge, MA, USA: MIT Press. ISBN 978-0-262-03561-3
- Milan Sonka; Vaclav Hlavac; Roger Boyle (2008). Image Processing, Analysis, and Machine Vision. Thomson. ISBN 978-0-495-08252-1
- Jurafsky, Daniel; Martin, James H. (2009). Speech and language processing : an introduction to natural language processing, computational linguistics, and speech recognition (Second edition ed.). Prentice Hall. ISBN 978-0-13-187321-6. OCLC 213375806
- Eisenstein, Jacob (2019). Introduction to natural language processing. Cambridge, Massachusetts: The MIT Press. ISBN 978-0-262-04284-0. OCLC 1080249173
分野全体について
- Ferraro, Francis; Mostafazadeh, Nasrin; Huang, Ting-Hao; Vanderwende, Lucy; Devlin, Jacob; Galley, Michel; Mitchell, Margaret (2015-09). “A Survey of Current Datasets for Vision and Language Research”. Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing (Lisbon, Portugal: Association for Computational Linguistics): 207–213. doi:10.18653/v1/D15-1021.
- Baltrušaitis, Tadas; Ahuja, Chaitanya; Morency, Louis-Philippe (2019-02). “Multimodal Machine Learning: A Survey and Taxonomy”. IEEE Transactions on Pattern Analysis and Machine Intelligence 41 (2): 423–443. doi:10.1109/TPAMI.2018.2798607. ISSN 1939-3539.
- Kafle, Kushal; Shrestha, Robik; Kanan, Christopher (2019). “Challenges and Prospects in Vision and Language Research”. Frontiers in Artificial Intelligence 2. doi:10.3389/frai.2019.00028/full. ISSN 2624-8212.
- Uppal, Shagun; Bhagat, Sarthak; Hazarika, Devamanyu; Majumder, Navonil; Poria, Soujanya; Zimmermann, Roger; Zadeh, Amir (2022-01-01). “Multimodal research in vision and language: A review of current and emerging trends” (英語). Information Fusion 77: 149–171. doi:10.1016/j.inffus.2021.07.009. ISSN 1566-2535.
- Mogadala, Aditya; Kalimuthu, Marimuthu; Klakow, Dietrich (2021-08-30). “Trends in Integration of Vision and Language Research: A Survey of Tasks, Datasets, and Methods” (英語). Journal of Artificial Intelligence Research 71: 1183–1317. doi:10.1613/jair.1.11688. ISSN 1076-9757.
それぞれのタスクについて
- Hossain, MD. Zakir; Sohel, Ferdous; Shiratuddin, Mohd Fairuz; Laga, Hamid (2019-02-04). “A Comprehensive Survey of Deep Learning for Image Captioning”. ACM Computing Surveys 51 (6): 1–36. doi:10.1145/3295748. ISSN 0360-0300.
- Sharma, Himanshu; Agrahari, Manmohan; Singh, Sujeet Kumar; Firoj, Mohd; Mishra, Ravi Kumar (2020-02). “Image Captioning: A Comprehensive Survey”. 2020 International Conference on Power Electronics IoT Applications in Renewable Energy and its Control (PARC): 325–328. doi:10.1109/PARC49193.2020.236619.
- Wang, Chaoyang; Zhou, Ziwei; Xu, Liang (2021-01). “An Integrative Review of Image Captioning Research” (英語). Journal of Physics: Conference Series 1748 (4): 042060. doi:10.1088/1742-6596/1748/4/042060. ISSN 1742-6596.
- Wu, Qi; Teney, Damien; Wang, Peng; Shen, Chunhua; Dick, Anthony; van den Hengel, Anton (2017-10-01). “Visual question answering: A survey of methods and datasets” (英語). Computer Vision and Image Understanding 163: 21–40. doi:10.1016/j.cviu.2017.05.001. ISSN 1077-3142.
- Datta, Ritendra; Joshi, Dhiraj; Li, Jia; Wang, James Z. (2008-04). “Image retrieval: Ideas, influences, and trends of the new age” (英語). ACM Computing Surveys 40 (2): 1–60. doi:10.1145/1348246.1348248. ISSN 0360-0300.
- Dureja, Aman; Pahwa, Payal (2017-12-28). “Image retrieval techniques: a survey”. International Journal of Engineering & Technology 7 (1.2): 215. doi:10.14419/ijet.v7i1.2.9231. ISSN 2227-524X.
- Latif, Afshan; Rasheed, Aqsa; Sajid, Umer; Ahmed, Jameel; Ali, Nouman; Ratyal, Naeem Iqbal; Zafar, Bushra; Dar, Saadat Hanif et al. (2019-08-26). “Content-Based Image Retrieval and Feature Extraction: A Comprehensive Review” (英語). Mathematical Problems in Engineering 2019: e9658350. doi:10.1155/2019/9658350. ISSN 1024-123X.
- Kapoor, Rajiv; Sharma, Deepak; Gulati, Tarun (2021-08-01). “State of the art content based image retrieval techniques using deep learning: a survey” (英語). Multimedia Tools and Applications 80 (19): 29561–29583. doi:10.1007/s11042-021-11045-1. ISSN 1573-7721.
- Krahmer, Emiel; van Deemter, Kees (2012-03). “Computational Generation of Referring Expressions: A Survey”. Computational Linguistics 38 (1): 173–218. doi:10.1162/COLI_a_00088.
- Qiao, Yanyuan; Deng, Chaorui; Wu, Qi (2021). “Referring Expression Comprehension: A Survey of Methods and Datasets”. IEEE Transactions on Multimedia 23: 4426–4440. doi:10.1109/TMM.2020.3042066. ISSN 1941-0077.
- He, Feijuan; Wang, Yaxian; Miao, Xianglin; Sun, Xia (2021-08-01). “Interpretable visual reasoning: A survey” (英語). Image and Vision Computing 112: 104194. doi:10.1016/j.imavis.2021.104194. ISSN 0262-8856.
サーベイ論文(コンピュータビジョンおよび自然言語処理について)
- Qiu, XiPeng; Sun, TianXiang; Xu, YiGe; Shao, YunFan; Dai, Ning; Huang, XuanJing (2020-10-01). “Pre-trained models for natural language processing: A survey” (英語). Science China Technological Sciences 63 (10): 1872–1897. doi:10.1007/s11431-020-1647-3. ISSN 1869-1900.
- Khan, Salman; Naseer, Muzammal; Hayat, Munawar; Zamir, Syed Waqas; Khan, Fahad Shahbaz; Shah, Mubarak (2021-12-07). “Transformers in Vision: A Survey”. ACM Computing Surveys. doi:10.1145/3505244. ISSN 0360-0300.
- Han, Kai; Wang, Yunhe; Chen, Hanting; Chen, Xinghao; Guo, Jianyuan; Liu, Zhenhua; Tang, Yehui; Xiao, An et al. (2022). “A Survey on Vision Transformer”. IEEE Transactions on Pattern Analysis and Machine Intelligence. doi:10.1109/TPAMI.2022.3152247. ISSN 0162-8828.
- Iqbal, Touseef; Qureshi, Shaima (2020-04-13). “The survey: Text generation models in deep learning” (英語). Journal of King Saud University - Computer and Information Sciences. doi:10.1016/j.jksuci.2020.04.001. ISSN 1319-1578.