サポートベクターマシン
サポートベクターマシン(英: support-vector machine, SVM)は、教師あり学習を用いるパターン認識モデルの1つである。分類や回帰へ適用できる。1963年にウラジミール・ヴァプニクとAlexey Ya. Chervonenkisが線形サポートベクターマシンを発表し[1]、1992年にBernhard E. Boser、Isabelle M. Guyon、ウラジミール・ヴァプニクが非線形へと拡張した。
| 機械学習および データマイニング |
|---|
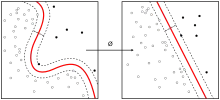 |
|
 Category:データマイニング |
サポートベクターマシンは、現在知られている手法の中でも認識性能が優れた学習モデルの1つである。サポートベクターマシンが優れた認識性能を発揮することができる理由は、未学習データに対して高い識別性能を得るための工夫があるためである。
基本的な考え方
サポートベクターマシンは、線形入力素子を利用して2クラスのパターン識別器を構成する手法である。訓練サンプルから、各データ点との距離が最大となるマージン最大化超平面を求めるという基準(超平面分離定理)で線形入力素子のパラメータを学習する。
最も簡単な場合である、与えられたデータを線形に分離することが可能な(例えば、3次元のデータを2次元平面で完全に区切ることができる)場合を考えよう。
このとき、SVMは与えられた学習用サンプルを、もっとも大胆に区切る境目を学習する。学習の結果得られた超平面は、境界に最も近いサンプルとの距離(マージン)が最大となるパーセプトロン(マージン識別器)で定義される。すなわち、そのようなパーセプトロンの重みベクトル を用いて、超平面は で表される。

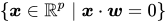
学習過程はラグランジュの未定乗数法とKKT条件を用いることにより、最適化問題の一種である凸二次計画問題で定式化される。ただし、学習サンプル数が増えると急速に計算量が増大するため、分割統治法の考え方を用いた手法なども提案されている。
概念的特長
次のような学習データ集合が与えられた場合を考える。

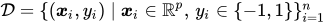
は1もしくは−1の値を持つ変数でが属したクラスを意味する。は次元の特徴ベクトルである。


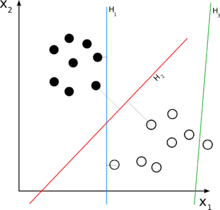
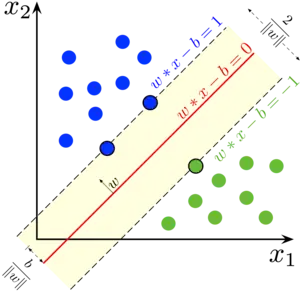
ニューラルネットワークを含む多くの学習アルゴリズムは、このような学習データが与えられた時であるいくつかの点とであるいくつかの点とを分離する超平面をさがすのが共通の目標である。SVMが他のアルゴリズムと差別化される特徴は、ただいくつかの点を分離する超平面を捜すことで終わるのではなく、いくつかの点を分離することができる幾多の候補平面の中でマージンが最大になる超平面 (maximum-margin hyperplane) を探す点にある。ここでマージンとは、超平面から各いくつかの点に至る距離の最小値を言い、このマージンを最大にしながらいくつかの点を2つのクラスで分類しようとすると、結局クラス1に属するいくつかの点との距離の中の最小値とクラス−1に属するいくつかの点との距離の中の最小値とが等しくなるように超平面が位置しなければならず、このような超平面をマージン最大の超平面という。結論として、SVMは2つのクラスに属しているいくつかの点を分類する幾多の超平面の中で、最大限に2つのクラスのいくつかの点と距離を維持するものを探すアルゴリズムといえる。


線形 SVM
以下のような形式の 個のトレーニング・データセットが与えられる。

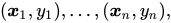
は1または−1であり、それぞれ、点が属するクラスを示す。は-次元の実数ベクトルである。となる点のグループととなる点のグループとを分ける「最大マージン超平面」を求めたい。この超平面は、超平面と各グループのもっとも近い点との距離が最大になるように定義される。
超平面は下記を満たす点の集合として記述できる。

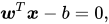
ここで、は超平面への法線ベクトルである。ヘッセ正規形とよく似ているが、は単位ベクトルとは限らない。原点から超平面までの法線ベクトルに沿った距離は、で求められる。


ハードマージン
学習データが線形分離可能であるとき、なるべくその距離が大きくなるように、2つのクラスのデータを分離するような、2つの平行な超平面を選択することができる。2つの超平面の間はマージン、2つの超平面の中間に位置する超平面は最大マージン超平面と呼ばれる。
正規化ないし標準化されたデータセットでは、これらの超平面は次の式で表される。
- (この境界以上の点は、全てラベル1)
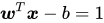
と
- (この境界以下の点は、全てラベル−1)
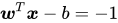
この2つの超平面の間の距離は、幾何学的には、点と平面の距離の公式を用いて、となる[2]。だから、超平面の間の距離を最大化するためには、 を最小化したい。


点がマージンに入らず、正しい側にいるための制約条件は、全てのに対し、以下の式が成立することである。

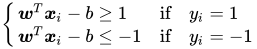
つまり、全てに対し、次のようになる。
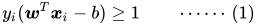
以上をまとめると、次の最適化問題が得られる。
- "Minimize subject to for ."
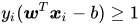

これを解いて得られるとを用いて、分類器を決定することができる。ここで、は符号関数である。

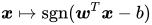

この幾何学的記述から、最大マージン超平面は、それと最も近い位置にあるによって定まるという重要な帰結が得られる。をサポートベクターと呼ぶ。
ソフトマージン
SVMを拡張して線形分離可能ではないデータを扱えるようにするためには、ヒンジ損失関数が有用である。
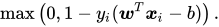
ここで、は番目のターゲット(すなわち、1または−1)であり、は番目の出力である。

この関数の値は、(1) の制約が満たされている場合、つまり、がマージンの正しい側にある場合にはゼロとなる。マージンの反対側にあるデータに対しては、関数の値はマージンからの距離に比例する。
最適化の目的は、以下を最小化することである。
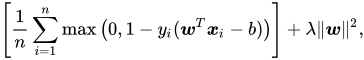
パラメータは、マージンサイズを大きくすることと、がマージンの正しい側にあることとのトレードオフを決定する。が充分に小さいとき、損失関数の第2項は無視可能になり、ハードマージンSVMと同様の振る舞いをする。

線形分離不可能な問題への適用
1963年にウラジミール・ヴァプニク、Alexey Ya. Chervonenkis が発表した初期のサポートベクターマシンは、線形分類器にしか適用できなかった。しかし、再生核ヒルベルト空間の理論を取り入れたカーネル関数を用いてパターンを有限もしくは無限次元の特徴空間へ写像し、特徴空間上で線形分離を行う手法が 1992年にBernhard E. Boser、Isabelle M. Guyon、ウラジミール・ヴァプニクらによって提案された。これにより、非線形分類問題にも優れた性能を発揮することがわかり、近年特に注目を集めている。
なお、カーネル関数を取り入れた一連の手法では、どのような写像が行われるか知らずに計算できることから、カーネルトリック (Kernel Trick) と呼ばれている。
主に下記のカーネル関数がよく使われていてLIBSVMでも実装されている。
SVM分類器の計算
ソフトマージンSVM分類器の計算は、次のような式を最小化することになる
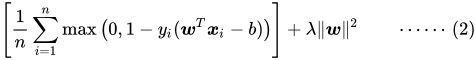
線形分離可能な入力データに対して、の値を充分に小さく取るとハードマージン分類器が得られる。以下に詳述する古典的なアプローチは、(2) を 二次計画法問題に帰着するものである。
主形式
(2) の最小化問題は、微分可能な目的関数を持つ制約付き最適化問題に書き換えることができる。
のそれぞれに対して変数を定義する。なお、は を満たす最小の非負の数である。
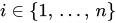
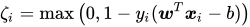

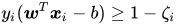
したがって、最適化問題を次のように書き換えることができる。
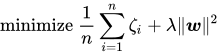
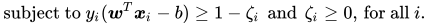
双対形式
次のような双対形式に帰着することができる。
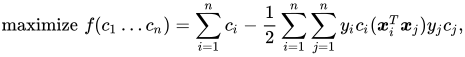
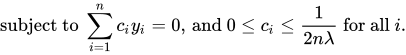
双対形式の最大化問題は、線形制約を前提としたの二次関数であり、二次計画法のアルゴリズムで効率的に解くことができる。

ここで、は次のように定義される。
- .
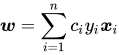
さらに、が正しい側にあるときはであり、がマージン境界にあるときはである。このことから、はサポートベクターの線形結合として書くことができる。

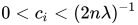
オフセットは、マージン境界上にを見つけ、次の式を解くことで復元することができる。
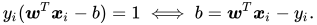
ここで、なのでとなることを利用した。


構造化SVM
2005年にIoannis Tsochantaridisらが構造化SVMを発表した[3]。任意のデータ構造を扱えるように拡張したものである。
通常の二値分類SVMは以下の値で分類する。
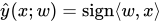
これは、このようにも書ける。
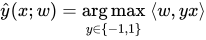
その上で、これを二値から一般の値に拡張する。 は入出力から特徴量を作り出す実数ベクトルを返す関数。問題ごとに定義する。

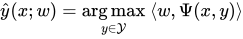
そして、下記の損失関数を最小化するように、最適化問題を解く。ここではL2正則化を付けている。は正則化の強さを表す定数。 は出力の類似度を表す実数を返す関数。問題ごとに定義する。であり、異なる値同士なら0よりも大きくなるように設計する。


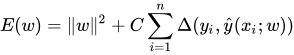
上記の最適化問題を解くには工夫が必要であり、その後も提案が続いているが、2005年に提案された方法は下記のように上界となる関数を作る。

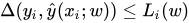
その上で、下記の最適化問題を解く。
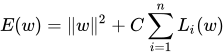
の作り方として2通りが提案された。
- マージンリスケーリング
- スラックリスケーリング
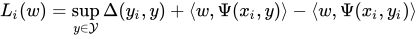
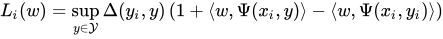
参照
- V. Vapnik and A. Lerner. Pattern recognition using generalized portrait method. Automation and Remote Control, 24, 1963.
- “Why is the SVM margin equal to ”. Mathematics Stack Exchange. 20150530閲覧。
- Ioannis Tsochantaridis; Thorsten Joachims; Thomas Hofmann; Yasemin Altun (2005). “Large Margin Methods for Structured and Interdependent Output Variables”. The Journal of Machine Learning Research 6 (9): 1453-1484.

関連項目
- カーネル法
- 逐次最小問題最適化法 (SMO)
- 人工知能
- パターン認識
- 放射基底関数
- 線形分類器
- 実装
- LIBSVM(一般)、LIBLINEAR(線形)
- scikit-learn(LIBSVM、LIBLINEARのPythonラッパーを含む)
| 標本調査 | |||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 要約統計量 |
| ||||||||||||||
| 推計統計学 |
| ||||||||||||||
| ベイズ統計学 |
| ||||||||||||||
| 相関 |
| ||||||||||||||
| モデル | |||||||||||||||
| 回帰 |
| ||||||||||||||
| 分類 |
| ||||||||||||||
| 教師なし学習 |
| ||||||||||||||
| 統計図表 | |||||||||||||||
| 生存分析 | |||||||||||||||
| 歴史 |
| ||||||||||||||
| 応用 | |||||||||||||||
| 出版物 |
| ||||||||||||||
| 全般 | |||||||||||||||
| その他 | |||||||||||||||
|
カテゴリ | |||||||||||||||