DCG
DCG(減損累積利得、げんそんるいせきりとく、Discounted cumulative gain)は、ランキング品質の評価指標である。情報検索において、DCG はウェブ検索エンジンのアルゴリズムや情報検索に関連したアプリケーションの適合性に対する有用性を評価するために使用される。DCG は検索エンジンの検索結果に含まれる文書の適合性を段階的に評価することで、検索結果リストにおける文書の位置(順位)によって、その文書の有用性、すなわち利得を測定する。この利得は、結果リストの上位から下位に向かって累積され、下位の文書ごとに各結果までの利得が割り引かれる[1]。
概要
DCG と DCG の類似指標が使用される場面は次の2つが想定される。
- 関連性の高い文書は、検索エンジンの結果リストの早い段階で表示される(ランクが高い)と、より有用性が高くなる。
- 関連性の高い文書は、適合性の低い文書よりも有用であり、その結果、適合性の低い文書よりも有用となる。
DCG は CG(累積利得)から拡張した指標である。
CG(累積利得)
CG(累積利得)は、検索結果の全結果のリストに対して段階的に適合性の評価を与え、それらを総和した指標である。DCG の前身概念である CG は、結果リストにおける結果の順位を、検索結果集合の有用性が考慮された結果リストが含まれない。ある順位 での CG は:

と定義する。
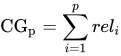
上記の は各順位 における文書の適合度を表す。


CGで算出された値は、検索結果に基づくランキングの順序の影響を受けない。つまり、適合度の高い文書 が適合度の低い文書 より高い順位に並び変わったとしても、CGの値は変動しない(ただし )。検索結果の有用性を測る指標は上記の2つの前提に基づいて、一般的に CG より (n)DCG が使用されている。


CG は評価尺度が二値分類であるとき、適合率と等しくなるため、"Graded Precision"(段階的適合率)と呼ばれることがある。
DCG(減損累積利得)
DCG における前提として、検索結果リストの下位に表示される適合性の高い文書にはペナルティを与えて、評価値は検索結果のランキングに比例して対数スケールで減少させることである。
最初期に提唱された、ある順位 まで累積した DCG は次のように定義される[1]:
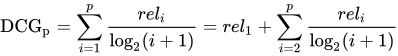
DCG が提唱された当時は、DCG の減損方法に対数を用いる妥当性は[2]、削減具合がなめらかであったこと以外に理論的に証明されていなかった。しかしワンら (2013)[3] によって nDCG(正規化減損累積利得)における対数による減損の妥当性が保証された。これは実質的に異なるランキングを評価する関数を対照的に、首尾一貫方法でそれらの関数による NDCG が優れているかを求めることで示した。
また2005年に提唱された適合度の高い文書に対しより高い評価を与えることを重視した DCG[4] が代替的に使用されている[5]:
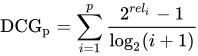
後者の式は一般的なウェブ検索企業[6][7]や Kaggle といったデータサイエンスの競技プラットフォームで用いらている指標となっている[8]。
これら2つの DCG の式は文書に対する適合度が の二値で与えられるとき等しくなる[2]:320。

なおクロフトら (2010) やバージェスら (2005) は下記の DCG 式の対数部分は自然対数として定義しているが、ここでは 2 を底とする対数を用いた DCG を定義している。第一式の DCG は対数の底の値によって nDCG の値は大きく変動しないが、第二式の DCG においては対数の底の値によって nDCG は大きな影響を受ける。これは明らかに、上記の DCG 式は対数の底によって割り引かれる程度が変動する。
nDCG(正規化減損累積利得)
検索結果の数は、クエリごとに数が異なる。あるクエリから次のクエリにおける検索エンジンの性能を比較するときに、ある順位 までの利得を累積する DCG 単体で性能を測定することはできないため、選択したある順位 までの累積利得を正規化する必要がある。DCG を正規化するために、コーパス上でクエリに関連する文書を DCG の値が最大化されるように順位 まで並べる(理想的リストとも呼ばれる[9]。)必要がある。順位 における DCG が最大化されたものは IDCG と呼ばれる。あるクエリに対する nDCG(normalized discounted cumulative gain)は:
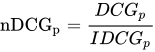
と定義される[10]。
このとき IDCG(理想的減損累積利得、ideal discounted cumulative gain)は:
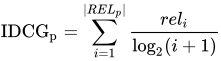
ただし はコーパス中における p 番目までの(適合度の高い順番に並べられた)理想的リストを表す。

任意のクエリに対する nDCG の値は検索エンジンに実装されているランキングアルゴリズムの平均的な性能指標を得るために各クエリの DCG の値を平均し得る。なお完璧なランキングアルゴリズムでの は と等しくなり、nDCGは 1.0 となる。また nDCG 値は 0.0 - 1.0 をとる相対的指標なので、クロスクエリにおいて比較可能である。


nDCG を使用する上での問題は、クエリに対する適合性フィードバックが一部にしか得られなかった場合、検索結果に対する理想的リストが正しく得られなくなることである。
例
検索クエリに対する文書のリストが与えられたときに、各文書のクエリに対する適合性を求める。各文書は、0: 関連がない、3: 関連がある、1, 2: 中間の評価として、0~3の値で判定する。文書に対してランキングアルゴリズムに則って評価値(ラベル)を順に与えるとき、各文書を
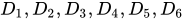
とおき、各文書ごとにクエリとの適合性の値を:

と与える。
このとき、 の適合性は 3、 の適合性は 2 である。この検索結果リストに対する CG(累積利得)は:


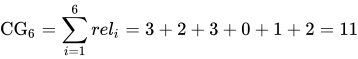
である。
検索結果リストの任意の2つの文書の順序を入れ替えることは CG の値に対し影響を与えない。ここで および を入れ替えると、CG は 11 と入れ替える前と同値ある。DCG は検索結果リスト内で早期に適合性の高い文書が表れるときに、高い値を与えるために使用される。対数スケールを用いて、各順位ごとの適合性に対して削減を行う DCG は次のように求まる:


| 1 | 3 | 1 | 3 |
| 2 | 2 | 1.585 | 1.262 |
| 3 | 3 | 2 | 1.5 |
| 4 | 0 | 2.322 | 0 |
| 5 | 1 | 2.585 | 0.387 |
| 6 | 2 | 2.807 | 0.712 |


このとき、上記のランキングにおける は:

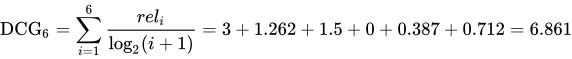
となる。
ここで、文書 と を入れ替えると、文書 より適合性の低い文書 が上位の検索結果となるため、DCG が減少する。つまり、適合性の高い文書が下位に含まれるほど順位に依存して割り引かれる。
DCG では、このクエリと他のクエリの性能の比較を行うには不適切な指標である。なぜならば、他のクエリはより多くの文書結果を持っているので、DCG の値は文書結果の数が多いほど、高くなり得るのでクエリの良し悪しを図りえないことがある。クエリごとの比較を行うには、DCG を正規化する必要がある。
正規化された DCG の値を求めるために、与えられたクエリに対する理想的リストを求める必要がある。例として、理想的リストの順序は適合性が与えられている文書の値が単調減少されるように並べ替えられる。ここで適合度が与えられた6つの文書に加えて、クエリに対する適合度が 3 の文書 、適合度が 2 の文書 がランキングの下位に存在すると仮定する。このときの理想的リストは:


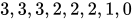
この理想的ランキングを分析するランキングの順位、つまり長さ6 まで再び選び取る:

この理想的な順序における DCG、つまり IDCG(Ideal DCG) はランク6のとき:
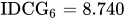
と求まる。
そして、このクエリにおける nDCG は次のように与えられる:
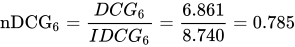
注意事項
- nDCG は検索結果のクエリに明らかに関連のない文書に対してペナルティを与えない。例えば、あるクエリが 1,1,1 と 1,1,1,0 の評価がなされた場合、後者の評価にそぐわない文書が含まれていたとしても、2つのスコアはnDCGにおいて同一に良い文書だとみなされてしまう。ここで適合度の評価を 2,1,0 から 1,0,-1 にする。このとき、適合性の低い文書の評価値を下げることで、再現率より適合率を重視した評価方法となっている。ただし、評価値の下限が負数となるので指標全体が 0 以下の評価値になり得ることに注意すべきである。
- nDCG は結果の評価が欠落した文書に対してペナルティを与えない。例えば、評価が 1,1,1 と 1,1,1,1,1 が与えられた場合、前者はランク3、後者はランク5までの DCG として計算してしまうと、どちらの評価も同一に良い文書だとみなされてしまう。この欠点を解消するための1つの方法は、結果集合のサイズを固定(先の例だとランク5に固定)し、欠損評価には評価の最小値を与えることにする。上記は、評価が 1,1,1,0,0 と 1,1,1,1,1 になり nDCG を両方とも nDCG@5 として計算することができる。
- nDCGは、複数の同一の評価が存在するとき、クエリの性能を測定するのに適さない場合がある。これは特に、実際に行うときに指標が最初の数結果のみだけで判断する場合に起こりえてしまう。例えば、「レストラン」というクエリで評価するとき、nDCG@1 では最初の結果のみに影響され、nDCG@5 でも同様な評価となった場合、後者の方が信頼性が高いにもかかわらず、評価は同様の値となってしまう。
脚注
- カレルヴォ・ジェルベリン 2002, pp. 422–446.
- ブルース・クロフト; ドナルド・メッツラー; トレバー・ストローマン (2010) (英語). Search Engines: Information Retrieval in Practice. Addison Wesley
- イーニン・ワン; リーウェイ・ワン; ユアンジ・リー; ディ・へ; ウェイ・チェン; 刘铁岩 [in 英語] (2013年). A Theoretical Analysis of Normalized Discounted Cumulative Gain (NDCG) Ranking Measures. In Proceedings of the 26th Annual Conference on Learning Theory (COLT 2013).
- クリス・バージェス; タル・シャクド; エリン・レンショー; アリ・レイジー; マット・ディーズ; ニコル・ハミルトン; グレッグ・ハレンダー (2005). Learning to rank using gradient descent. In Proceedings of the 22nd international conference on Machine learning (ICML '05). New York, NY, USA: ACM. pp. 89–96. doi:10.1145/1102351.1102363。
- 数原良彦『多様な情報源に対するランキング学習に関する研究』(博士(工学)論文・理工学研究科専攻)慶應義塾大学大学院理工学研究科、2014年、7-8頁。学位授与番号: 甲第4137号。
- “Introduction to Information Retrieval - Evaluation” (英語). Stanford University (2013年4月21日). 2014年3月23日閲覧。
- 酒井哲也 2015, p. 34.
- “Normalized Discounted Cumulative Gain”. 2014年3月23日時点のオリジナルよりアーカイブ。2014年3月23日閲覧。
- 酒井哲也 2015, pp. 32–34.
- カレルヴォ・ジェルベリン 2002, pp. 426–427, 435–445.
- クリス・バージェス (2005年8月). “Learning to Rank using Gradient Descent” (PDF) (英語). 2022年6月14日閲覧。
参考文献
- カレルヴォ・ジェルベリン; ヤーナ・ケカライネン (2002). “Cumulated gain-based evaluation of IR techniques”. Transactions on Information Systems (ACM) 20 (4): 422–446.
- 酒井哲也『情報アクセス評価方法論 : 検索エンジンの進歩のために』コロナ社、2015年。ISBN 9784339024968。 NCID BB18665252。
関連項目
- 評価指標 (情報検索)
- ランキング学習